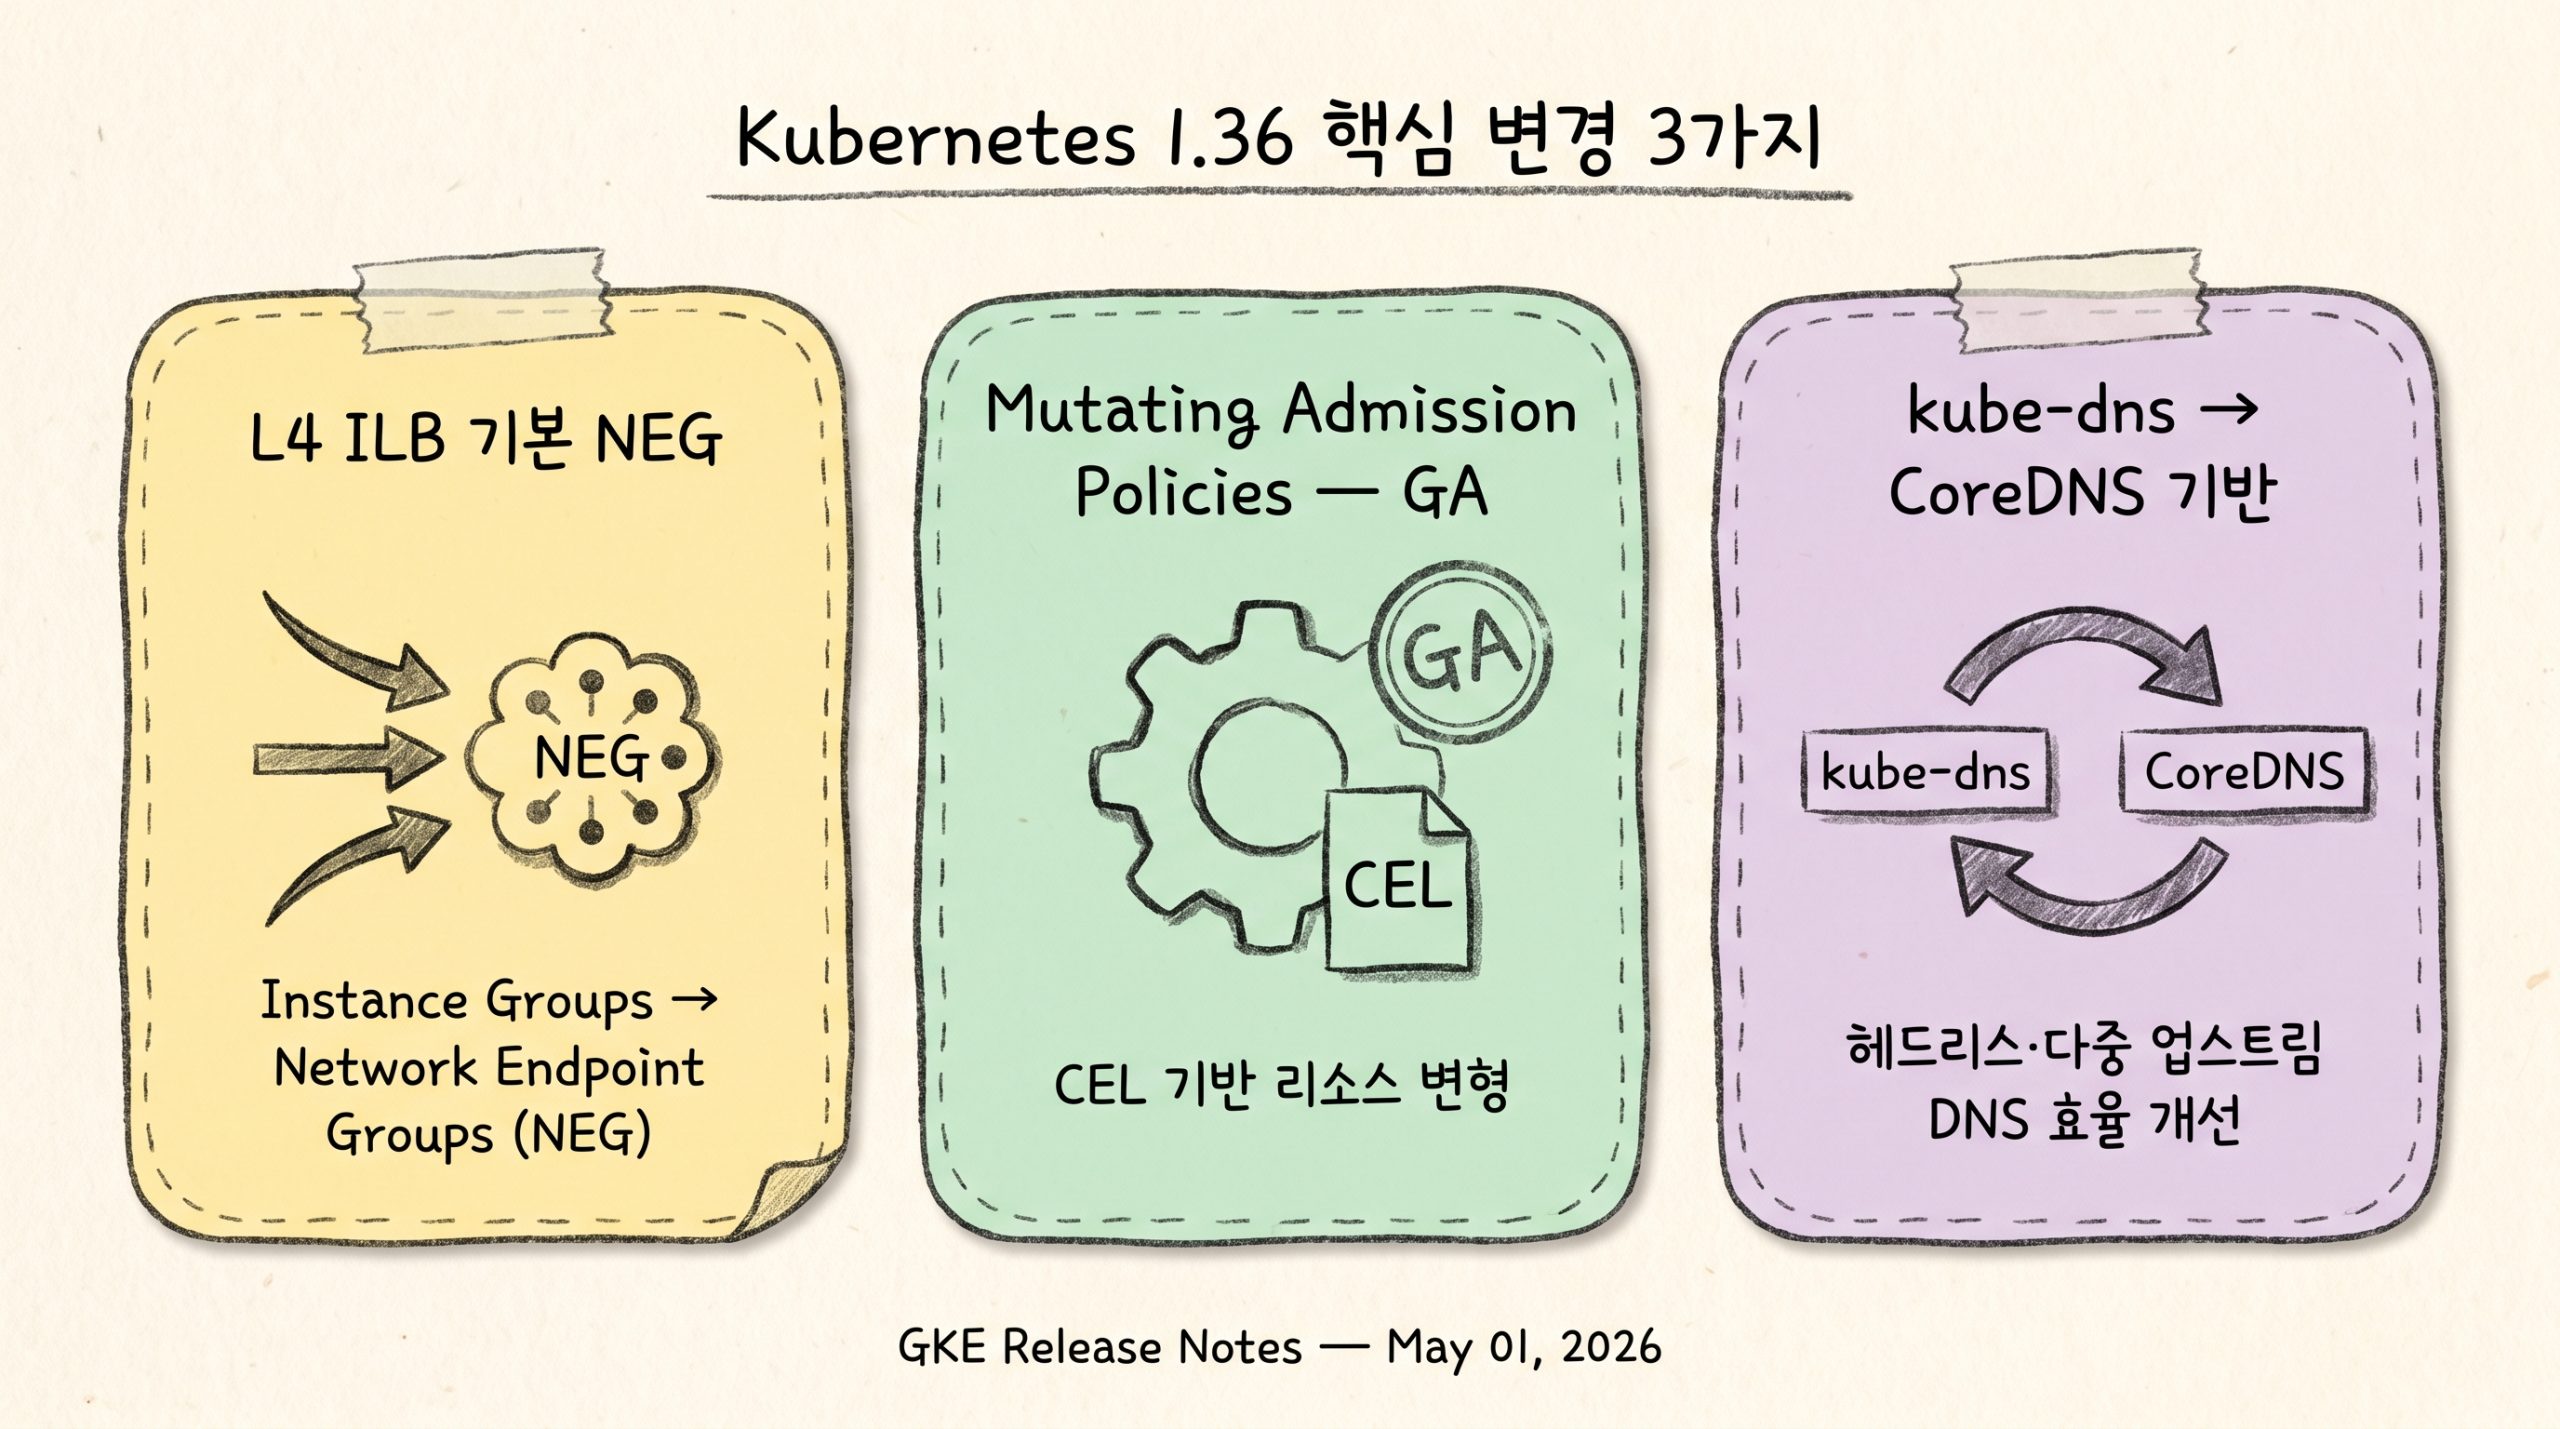
GKE 2026년 5월 릴리즈 노트 요약
2026년 5월에 공개된 GKE 릴리즈 노트의 주요 변경 사항을 한국어로 정리합니다. 출시일 기준 May 01 ~ May 14, 2026에 게시된 항목을 다룹니다. 한 눈에 보기 GKE 2026년 5월 한눈에 보기 — 주요 변경 사항 요약 Kubernetes 1.36 — Rapid 채널 출시 (May 01) Kubernetes 1.36 주요 GKE 관련 변경 — L4 ILB NEG…

2026년 5월에 공개된 GKE 릴리즈 노트의 주요 변경 사항을 한국어로 정리합니다. 출시일 기준 May 01 ~ May 14, 2026에 게시된 항목을 다룹니다. 한 눈에 보기 GKE 2026년 5월 한눈에 보기 — 주요 변경 사항 요약 Kubernetes 1.36 — Rapid 채널 출시 (May 01) Kubernetes 1.36 주요 GKE 관련 변경 — L4 ILB NEG…
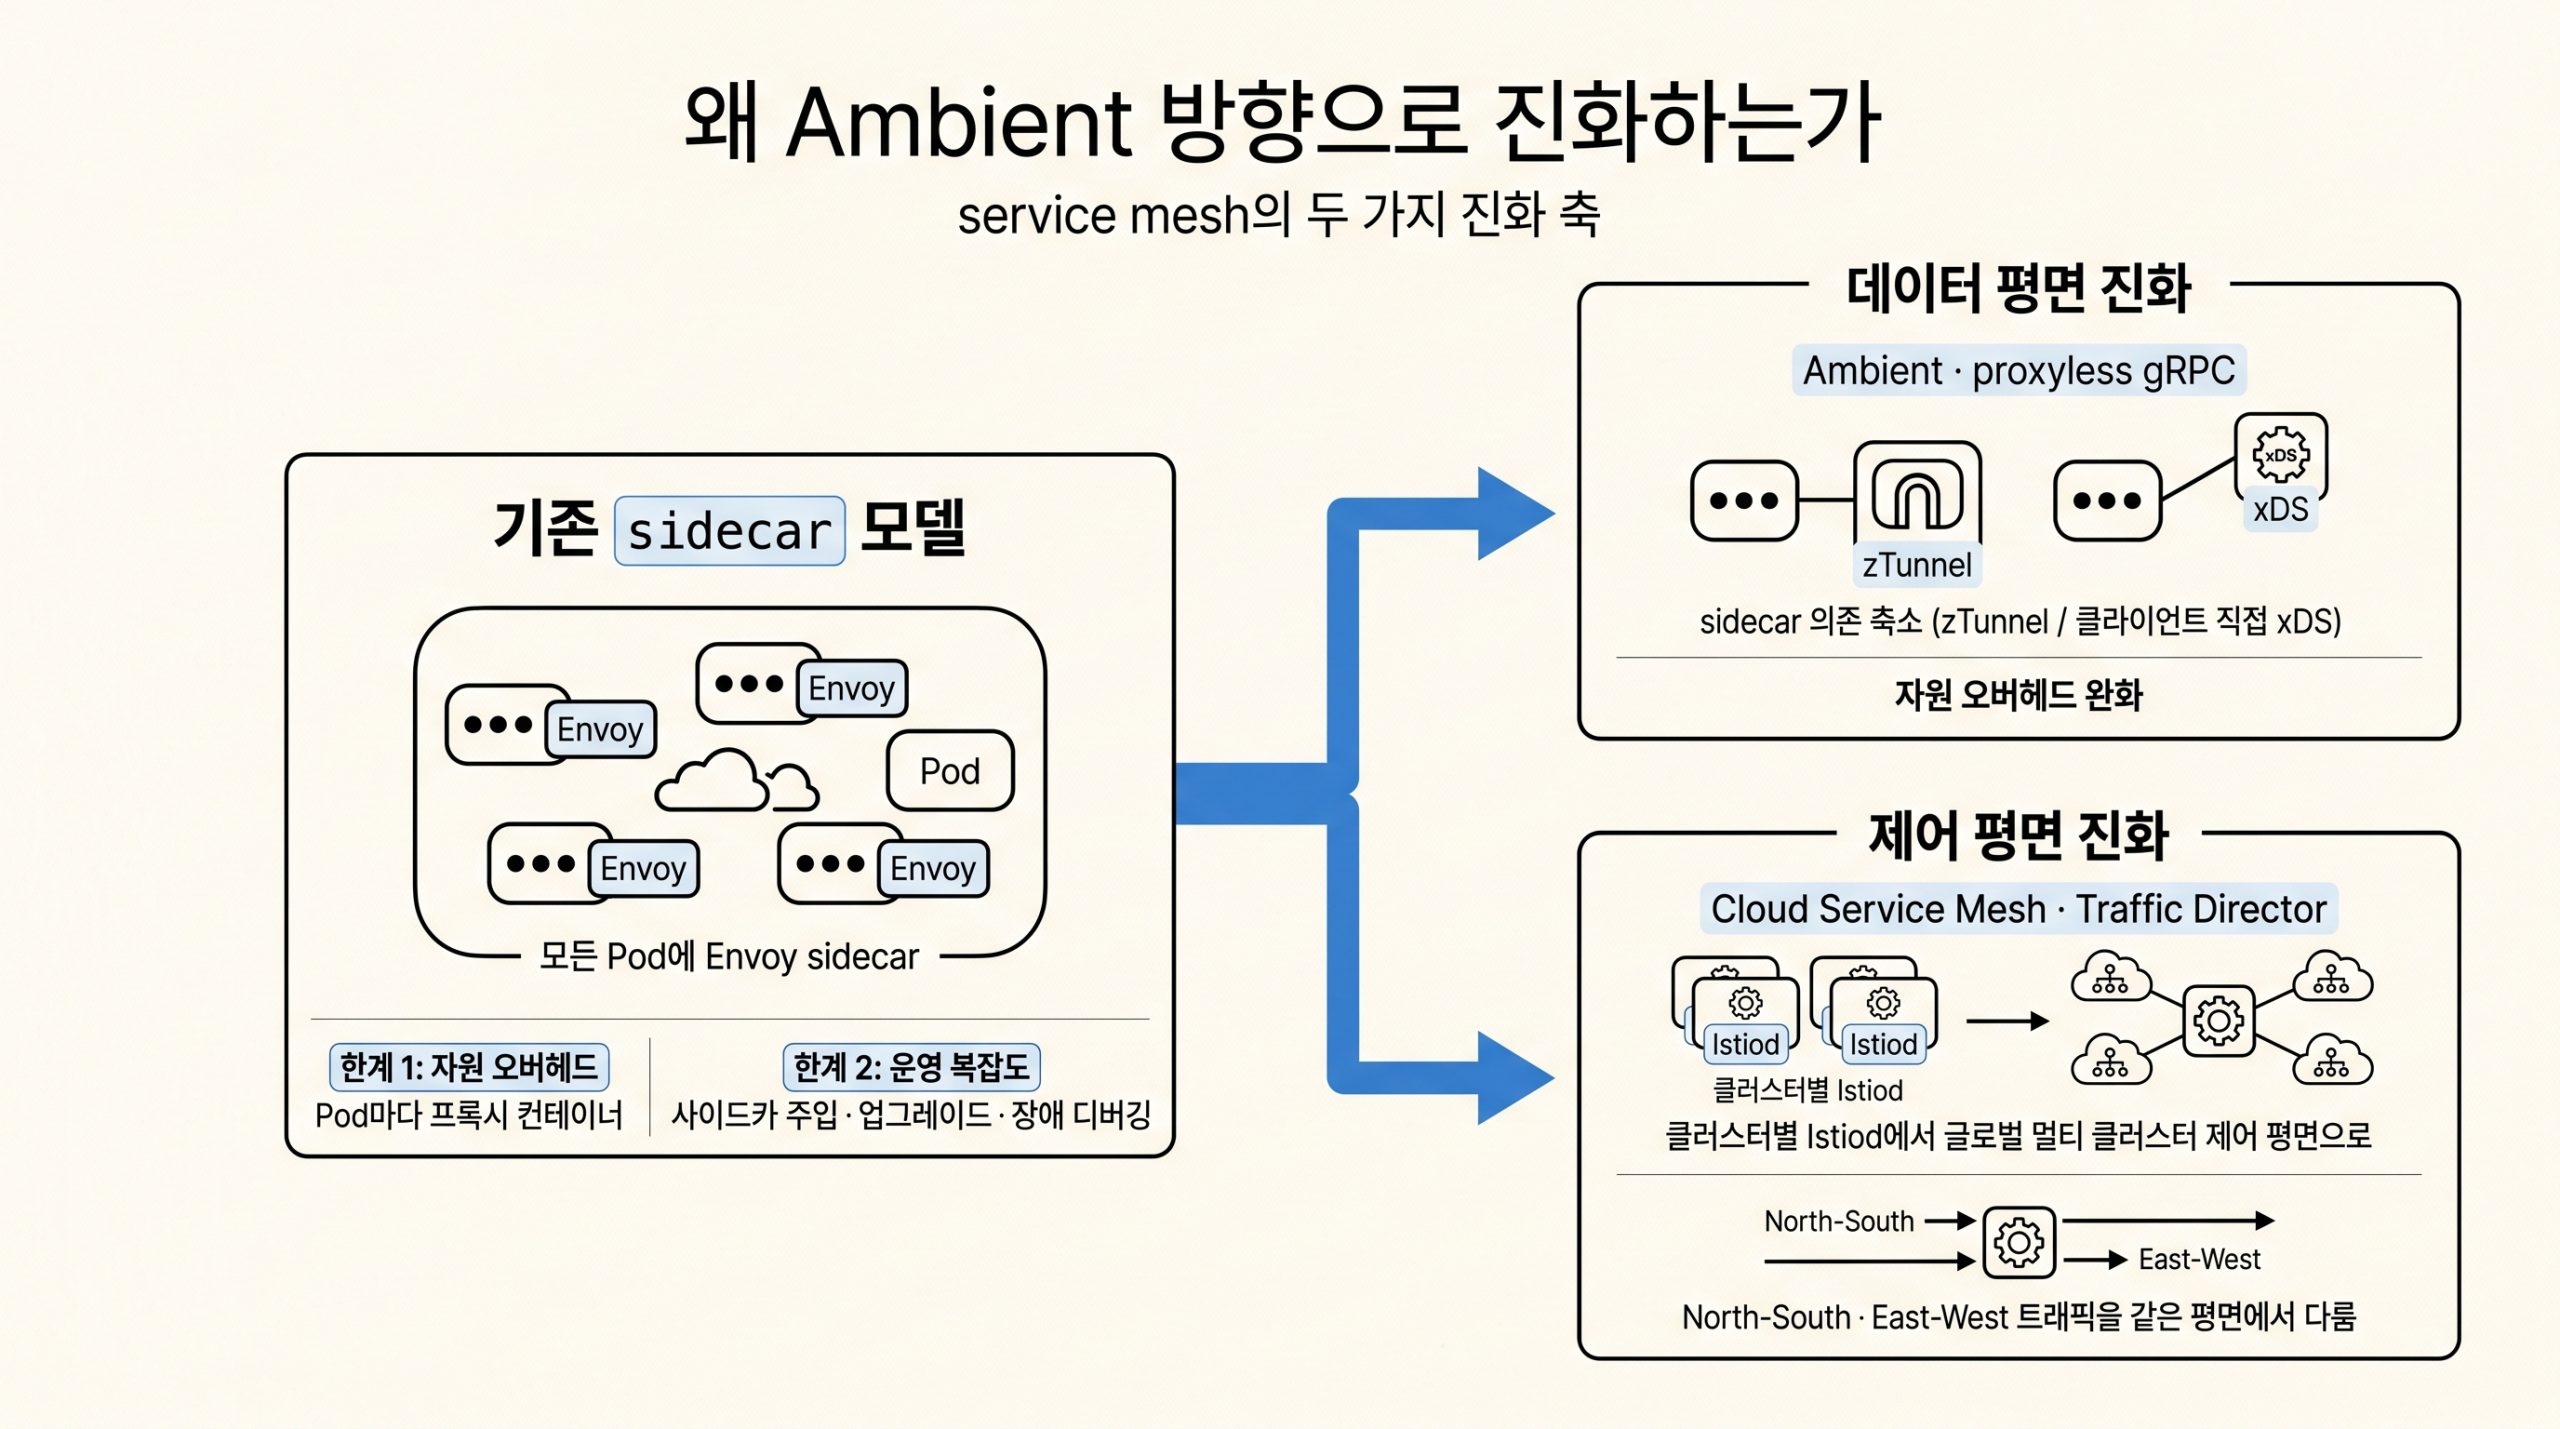
외전: Ambient 네트워킹과 Cloud Service Mesh Cloud Service Mesh는 Envoy와 Istio API를 데이터 평면·제어 평면 표준으로 삼는 구글 쿠버네티스 엔진(GKE)의 service mesh 제품입니다. Google Cloud Next 2026 발표는 추론·학습·보안 축의 신기능에 무게가 실려 있었지만, 이들 워크로드가 실제로 사용자 트래픽과 만나는 지점은 결국 mesh 위에 놓입니다. 본 글은 본 시리즈 외전입니다. Cloud Service Mesh가 East-West 트래픽과…
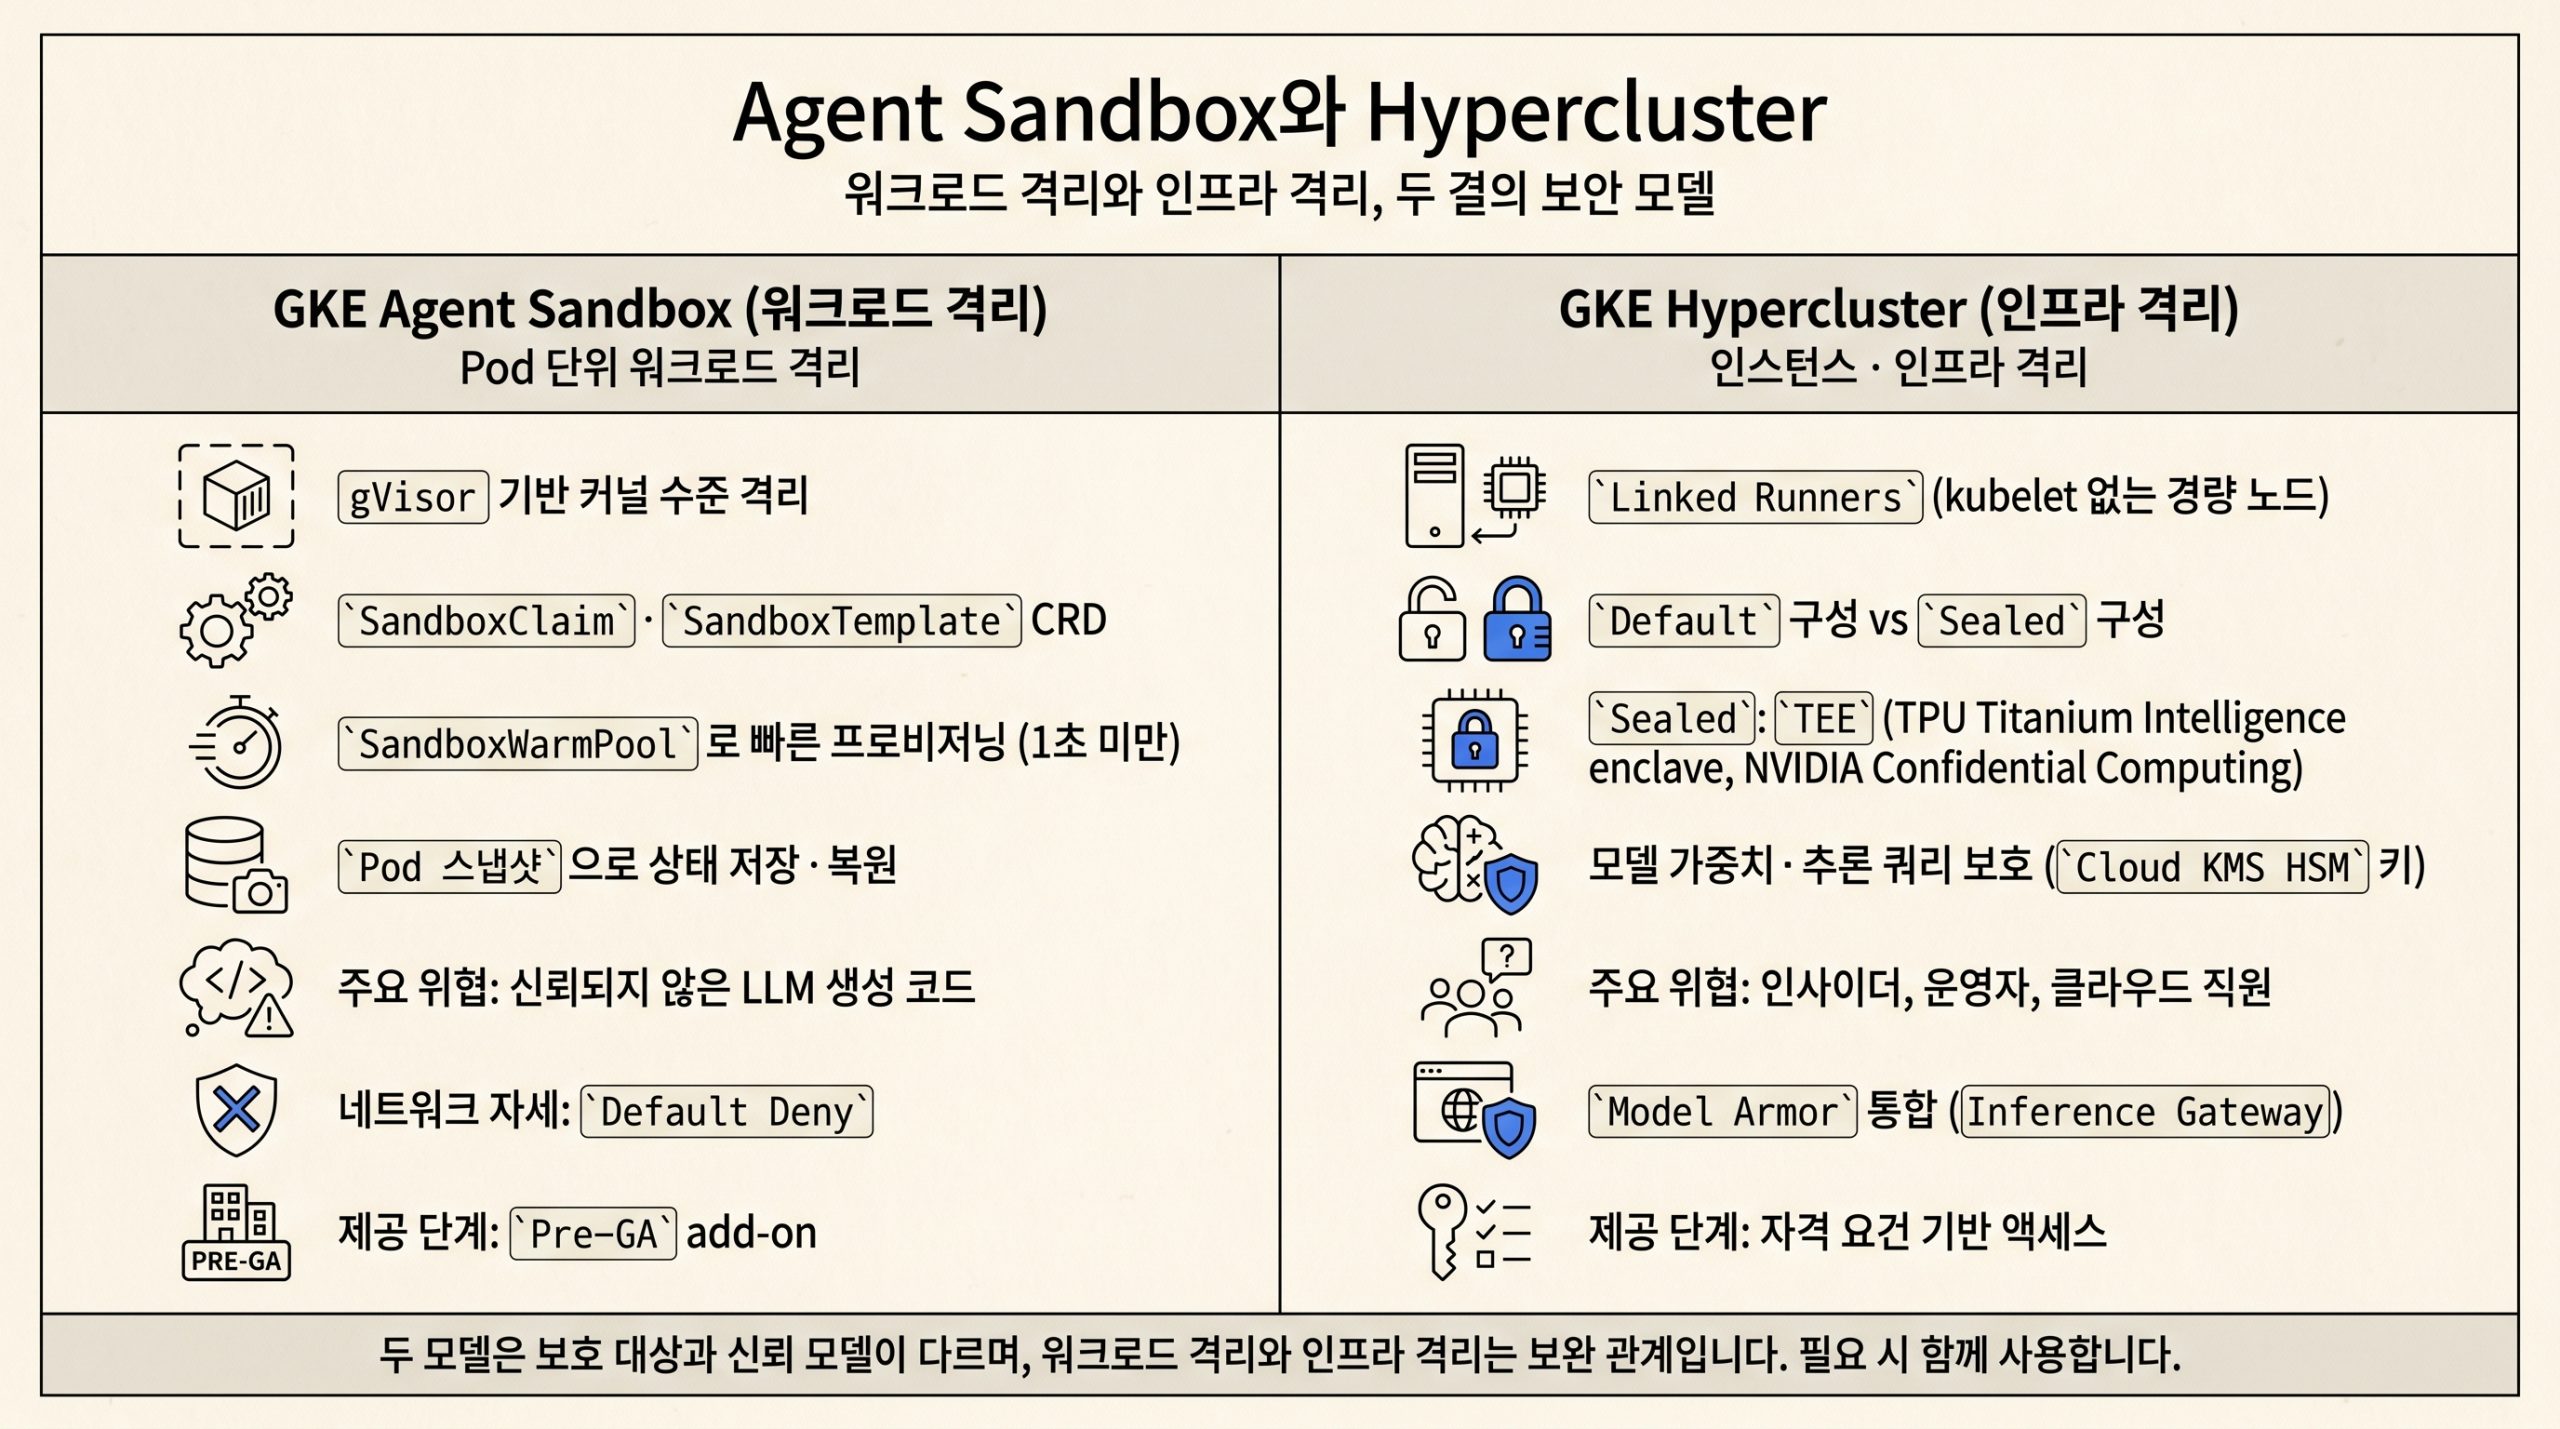
8편: 보안과 격리, Agent Sandbox와 Hypercluster GKE Agent Sandbox와 GKE Hypercluster는 구글 쿠버네티스 엔진(GKE) 위에서 동작하는 두 보안 기능으로, Google Cloud Next 2026에서 한 묶음으로 강조되었습니다. 한쪽은 워크로드 단위로 신뢰되지 않은 코드를 가두고, 다른 한쪽은 클러스터 인프라 자체를 봉인해 가중치와 쿼리를 보호합니다. 본 글은 두 기능의 개념과 구성 요소, 동작 방식을 한 편에 정리해 보안…
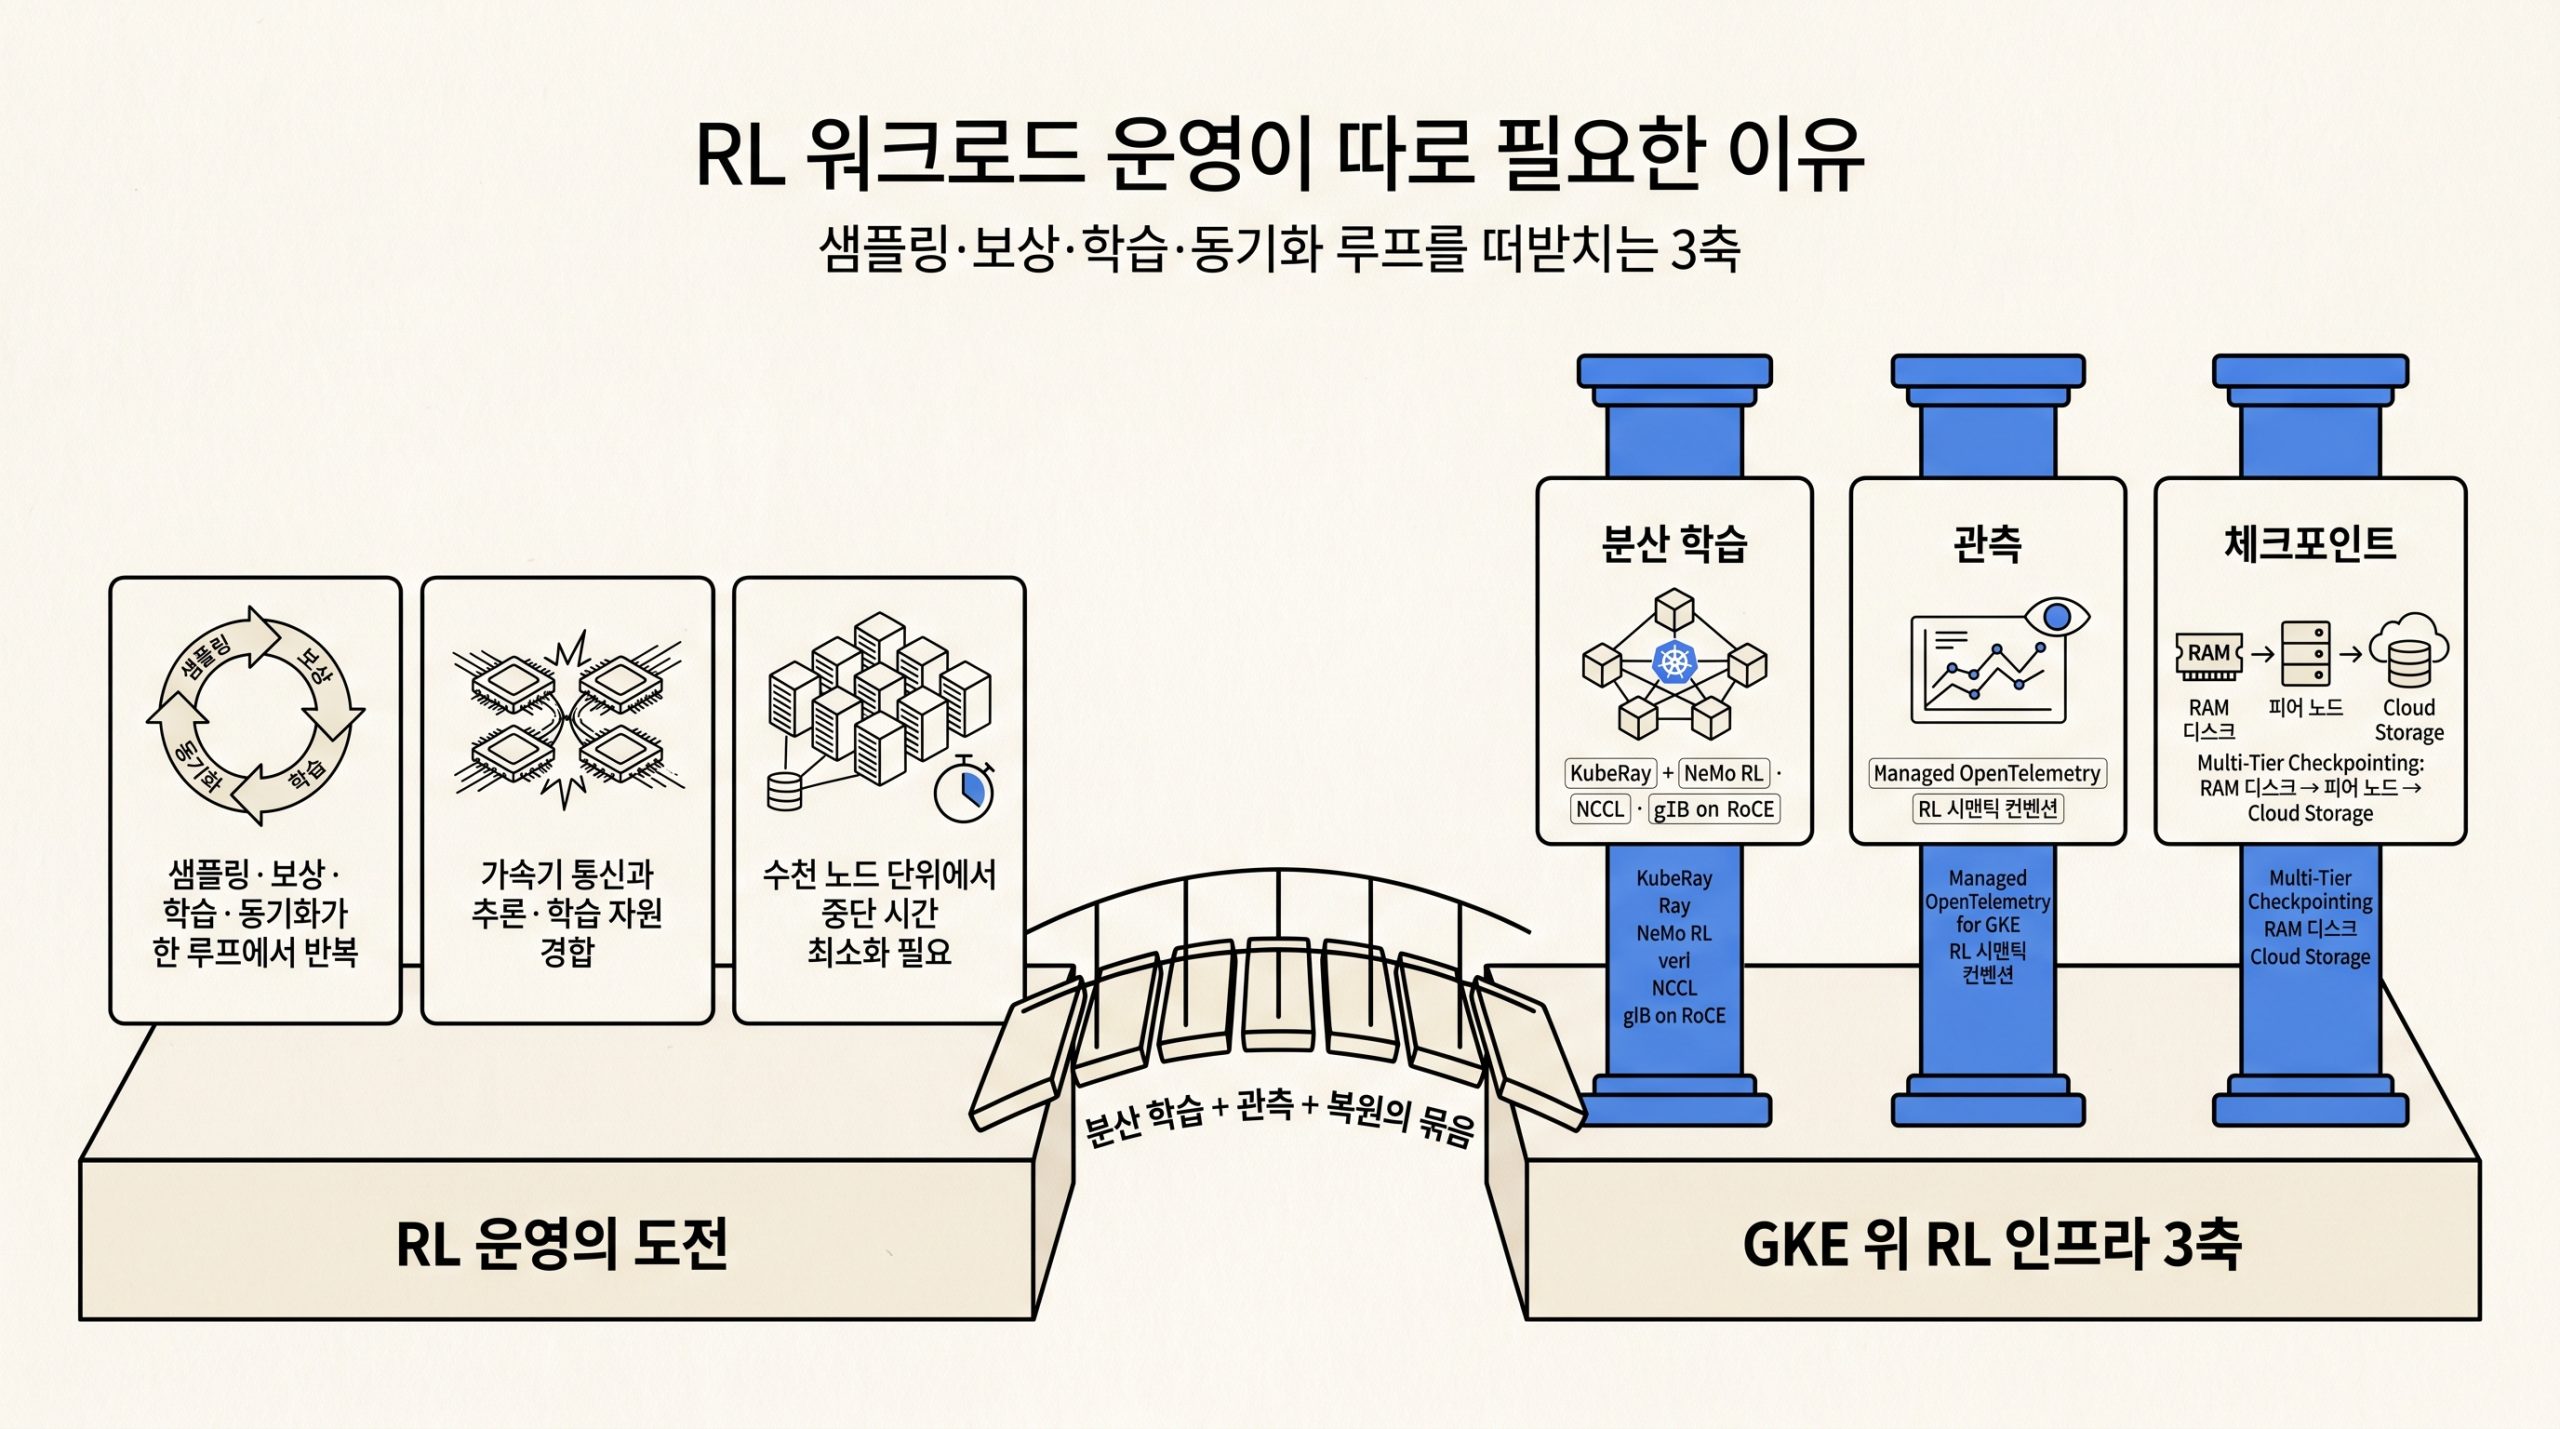
7편: 강화학습 워크로드 운영 대규모 언어 모델(LLM) 강화학습은 지도학습과 다르게 샘플링, 보상 계산, 학습, 동기화가 한 루프에서 돌아갑니다. 루프가 길어지면 노드 한 곳의 장애가 전체 진행을 멈추고, 수천 노드 규모에서는 중단이 시간 단위로 잦아집니다. Google Cloud Next 2026에서 구글 쿠버네티스 엔진(GKE)은 이 워크로드를 받아내기 위한 분산 학습, 관측, 체크포인트 세 축을 정리했습니다. 본 글은 NVIDIA…
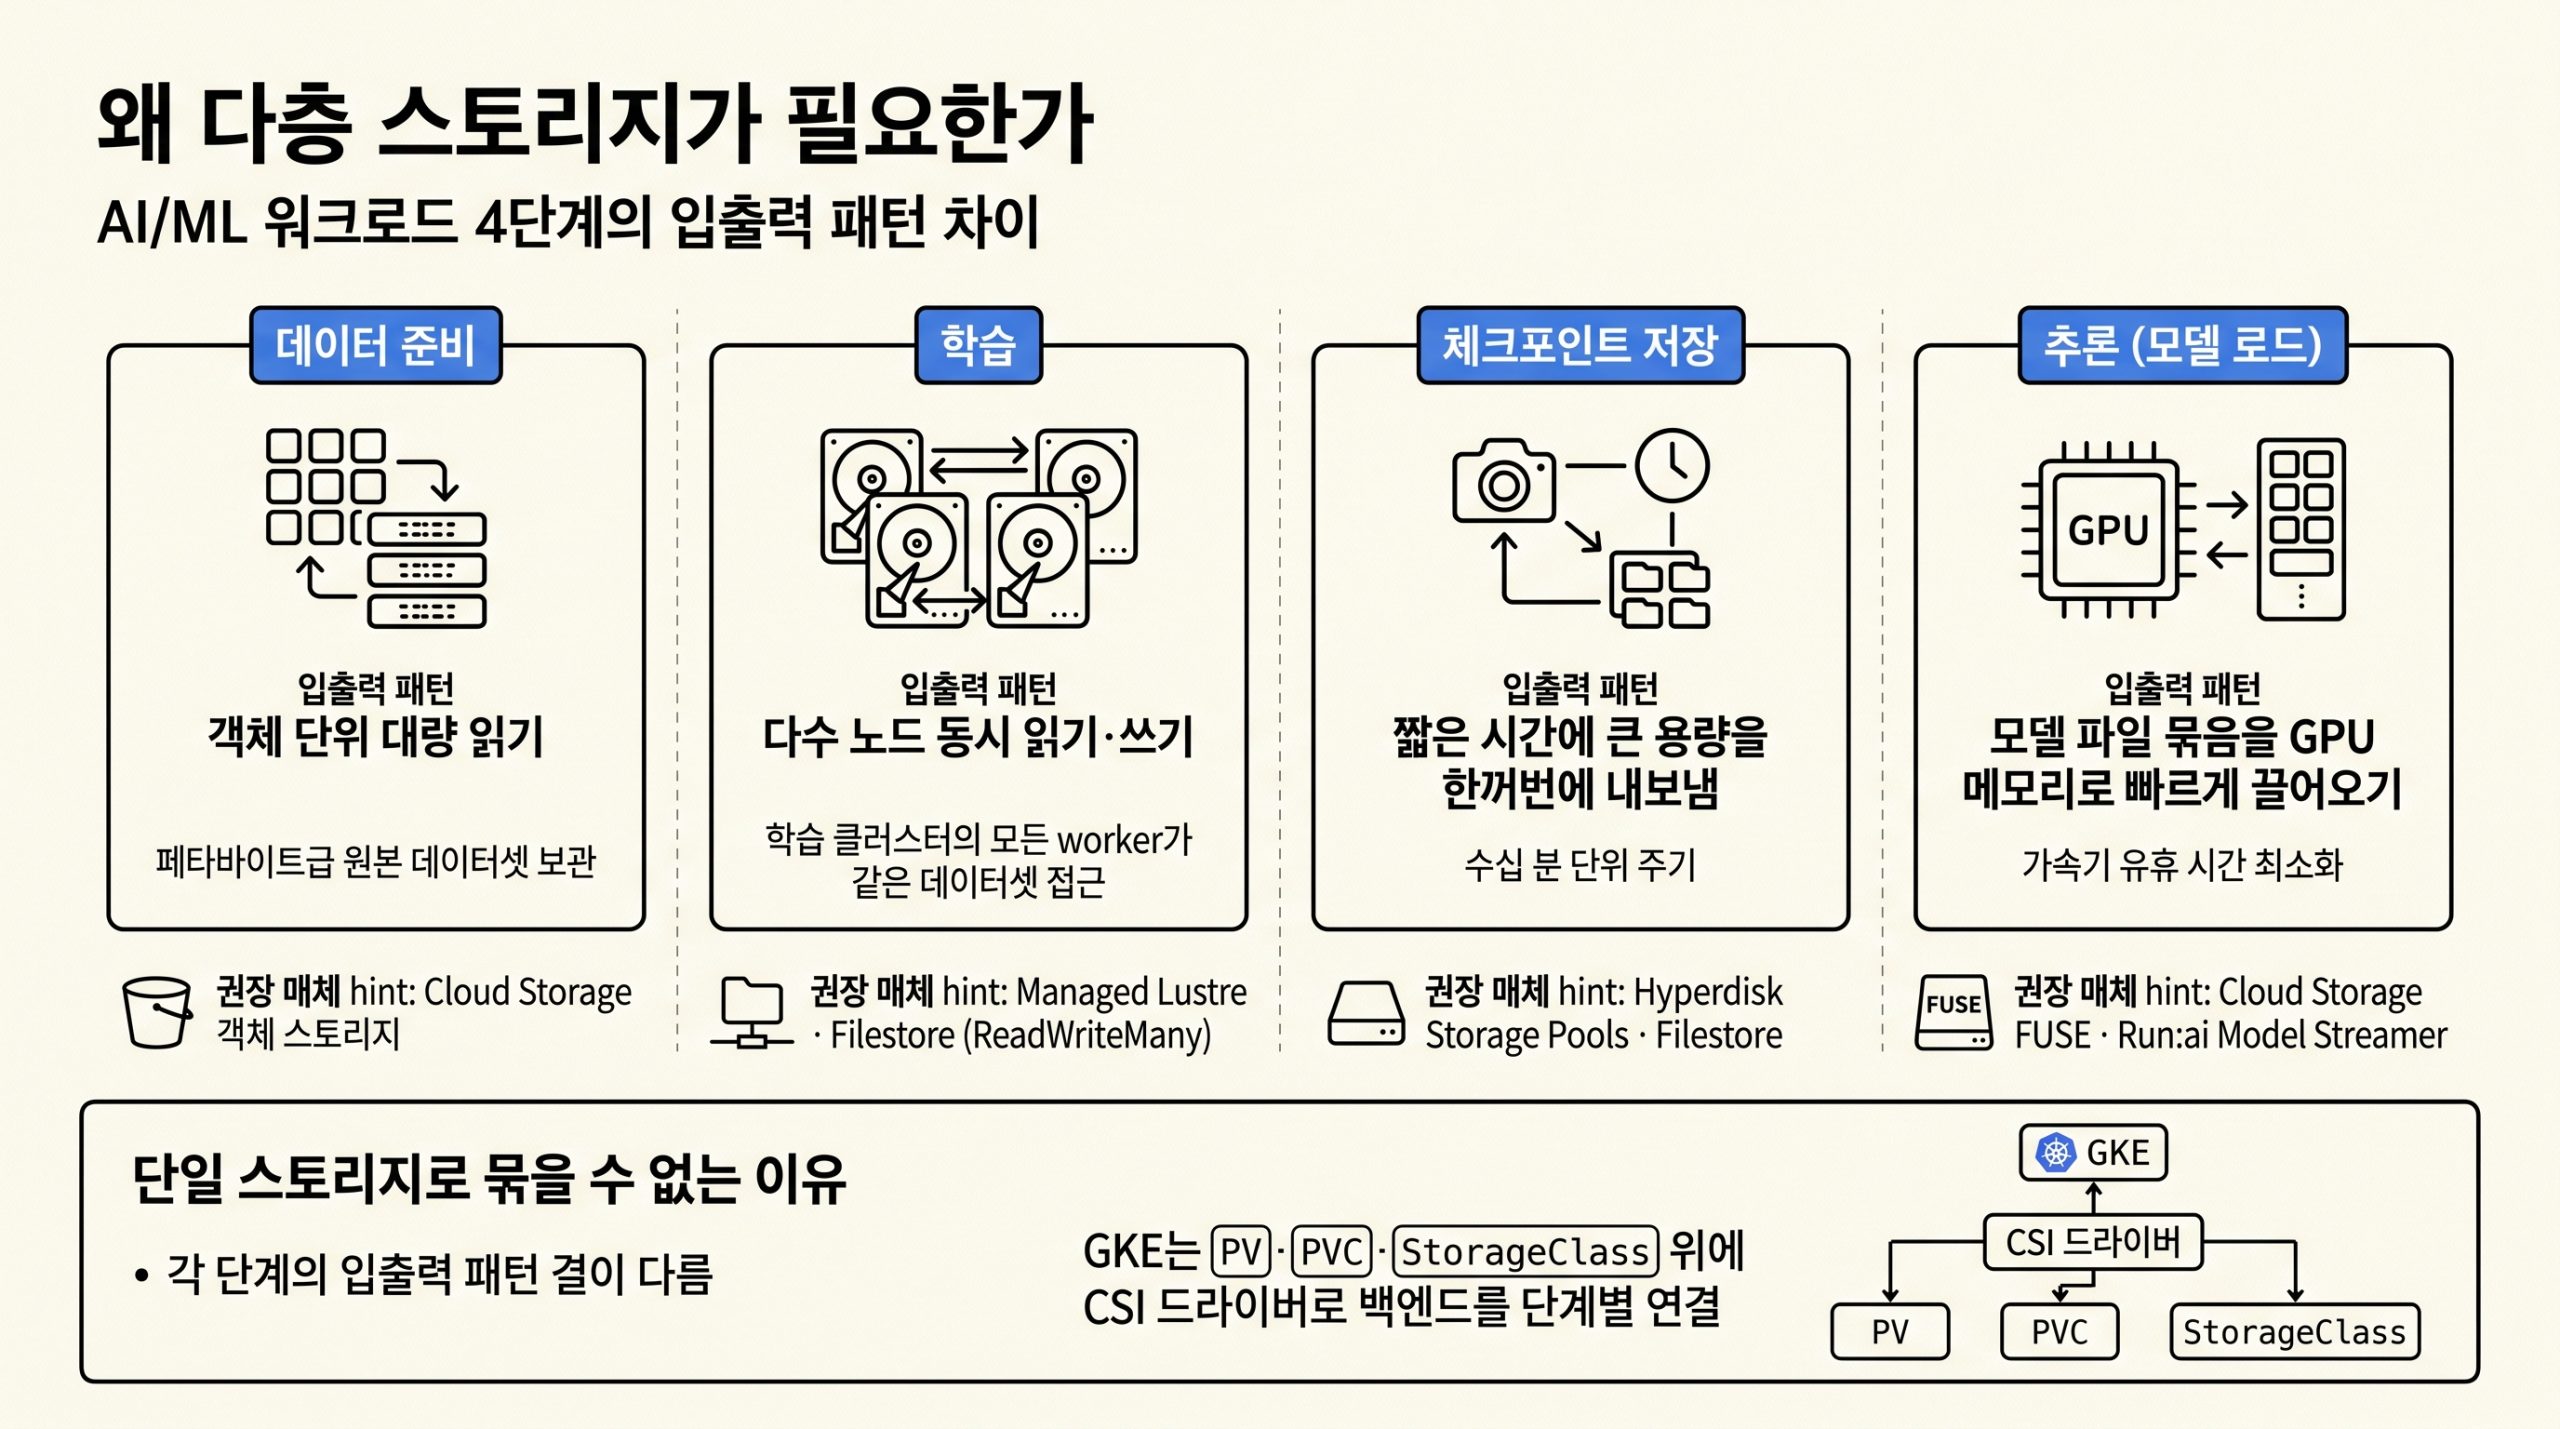
6편: AI 스토리지 다층 전략 AI/ML 워크로드는 한 가지 스토리지로 처리되지 않습니다. 데이터 준비 단계에서 거대한 원본 데이터셋을 모아두는 곳과 학습 도중 체크포인트를 빠르게 쓰는 곳, 추론 시점에 모델 가중치를 GPU로 끌어올리는 곳은 요구 조건이 다릅니다. 본 글은 구글 쿠버네티스 엔진(GKE)이 제공하는 스토리지 옵션을 워크로드 단계별로 어떻게 매핑하는지 정리합니다. 이 글은 학습 인프라 축에 속합니다…
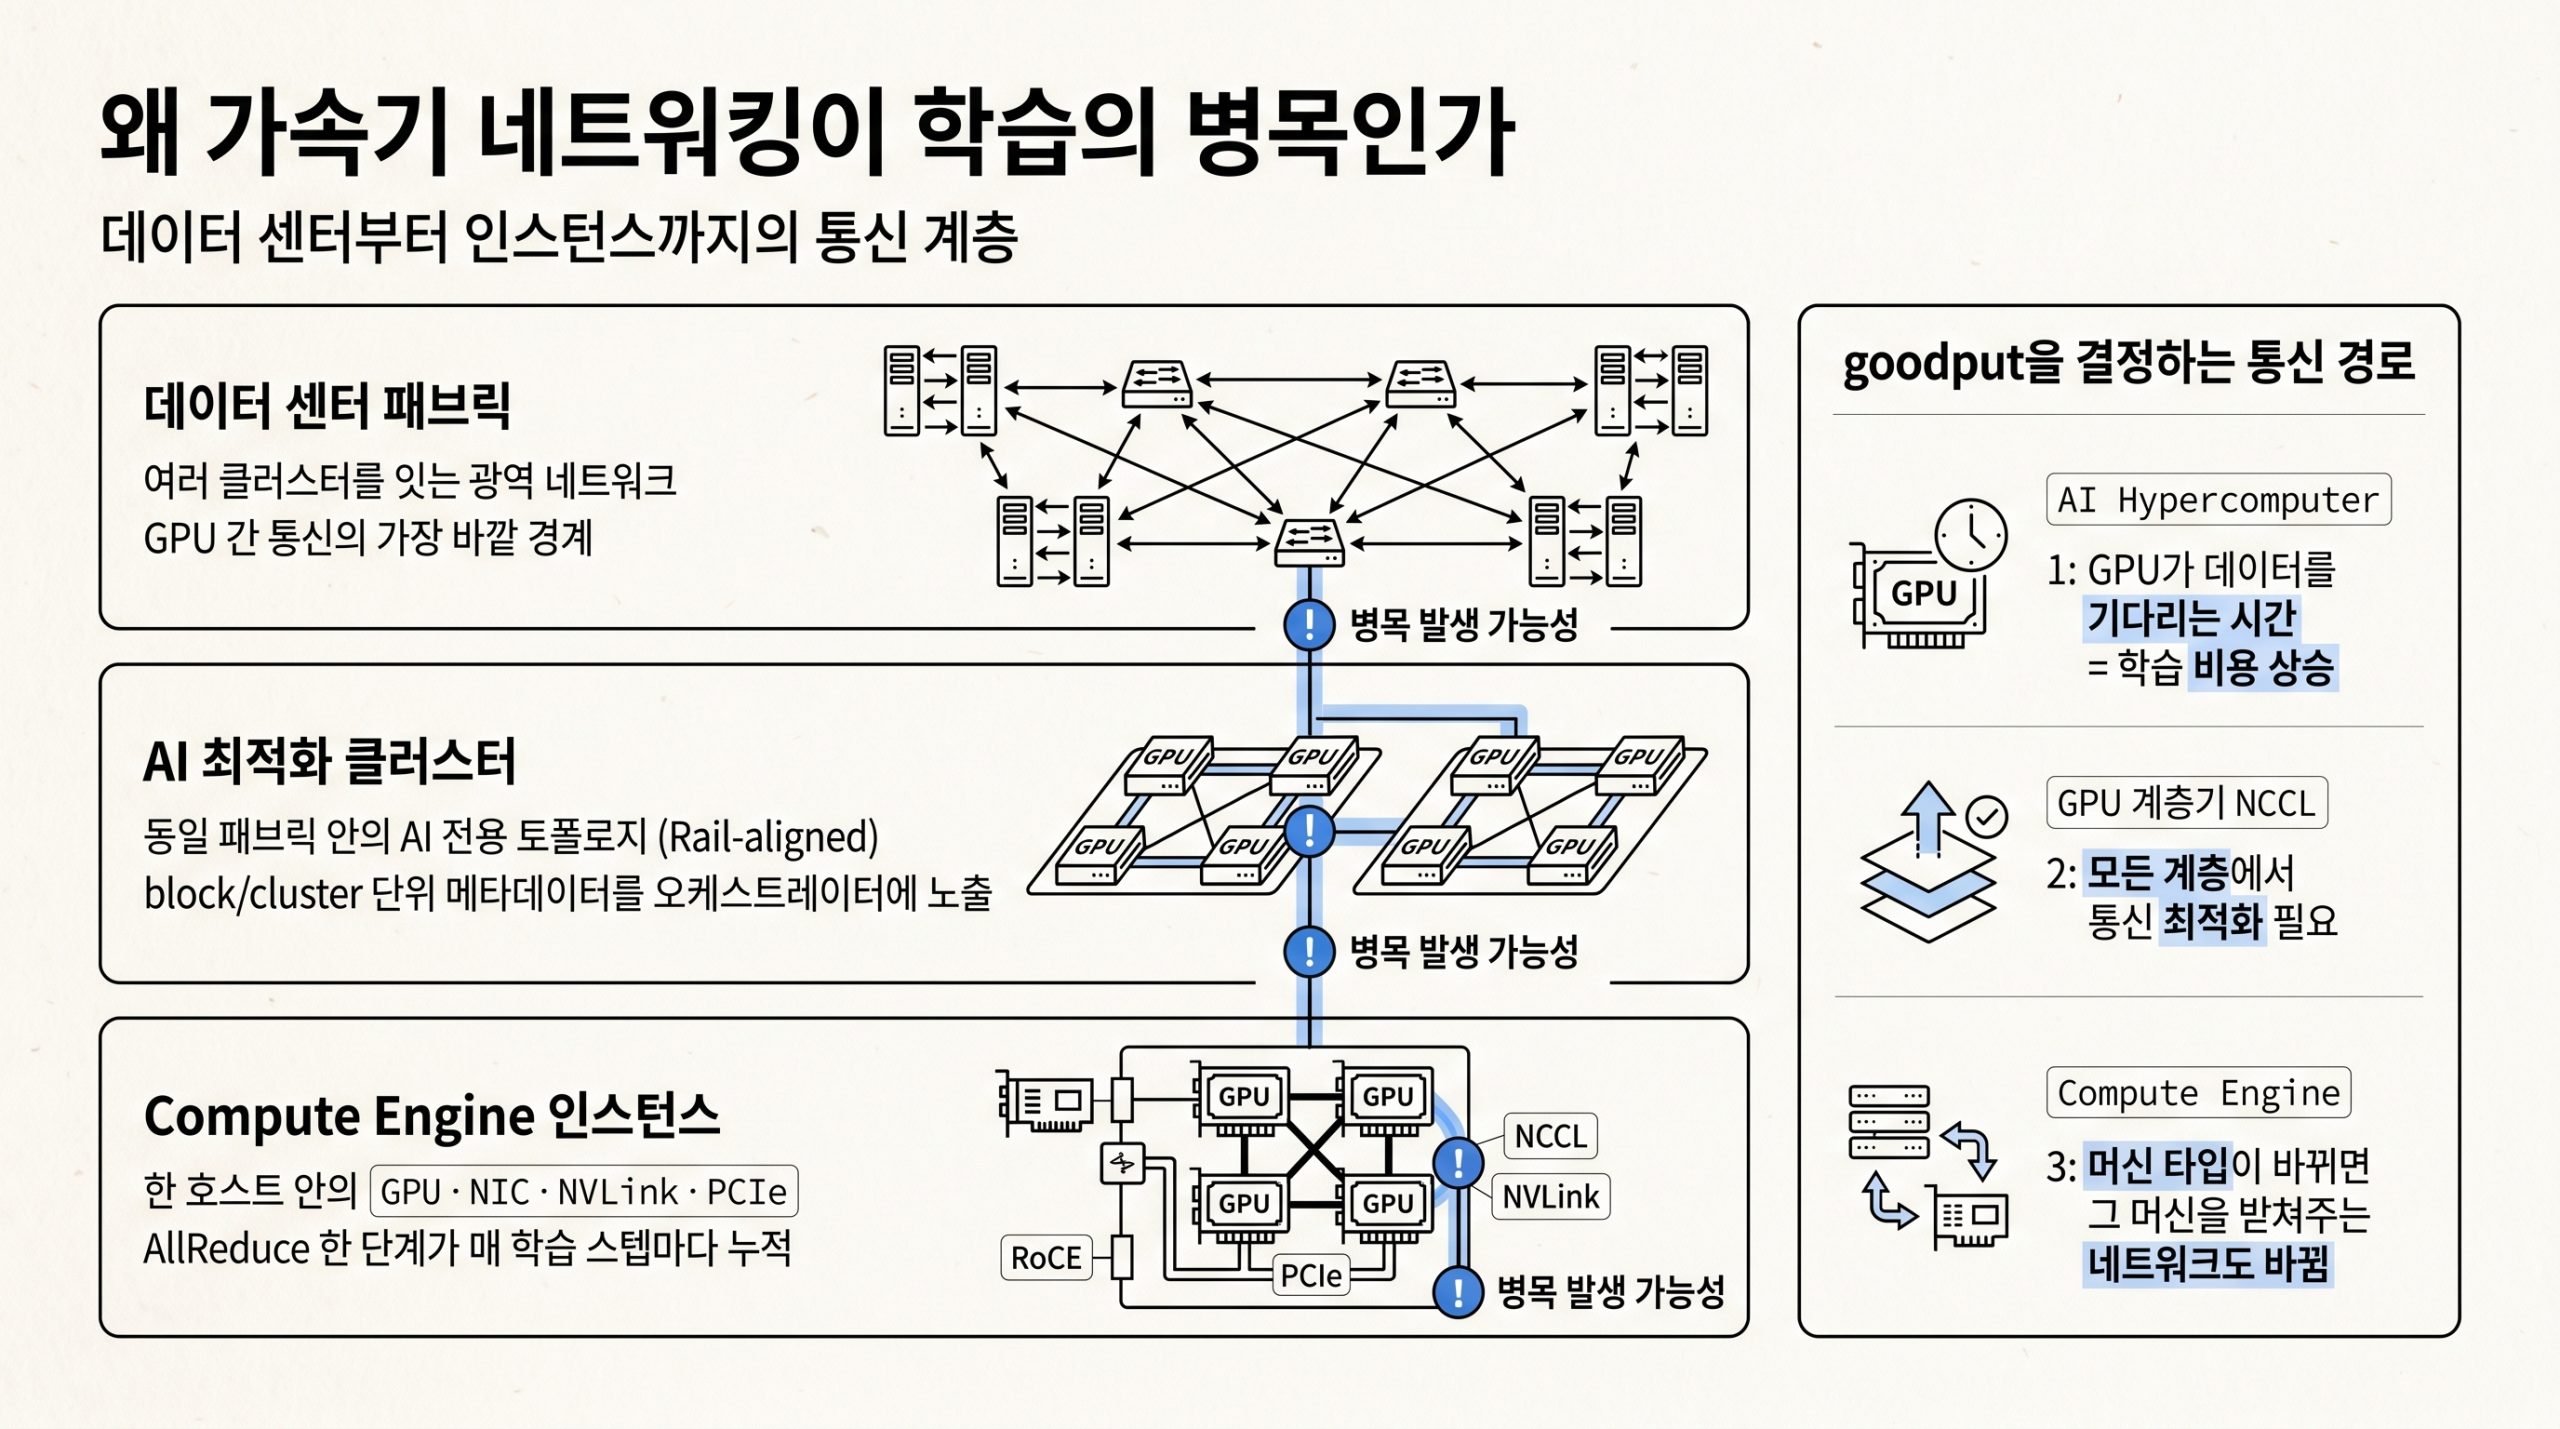
5편: 가속기 네트워킹, NCCL과 gIB와 A4X 대규모 학습은 가속기 한 장이 아니라 수백·수천 장이 함께 한 모델을 학습합니다. 이때 GPU 사이의 통신이 학습 시간을 결정합니다. AllReduce 한 단계가 길어지면 매 스텝마다 그만큼이 누적되고, 결국 토큰당 학습 비용이 올라갑니다. AI Hypercomputer는 이 통신 경로를 하드웨어와 소프트웨어 양쪽에서 손봤습니다. 본 글은 GPU-to-GPU 트래픽을 떠받치는 Rail-aligned 토폴로지, NCCL과…
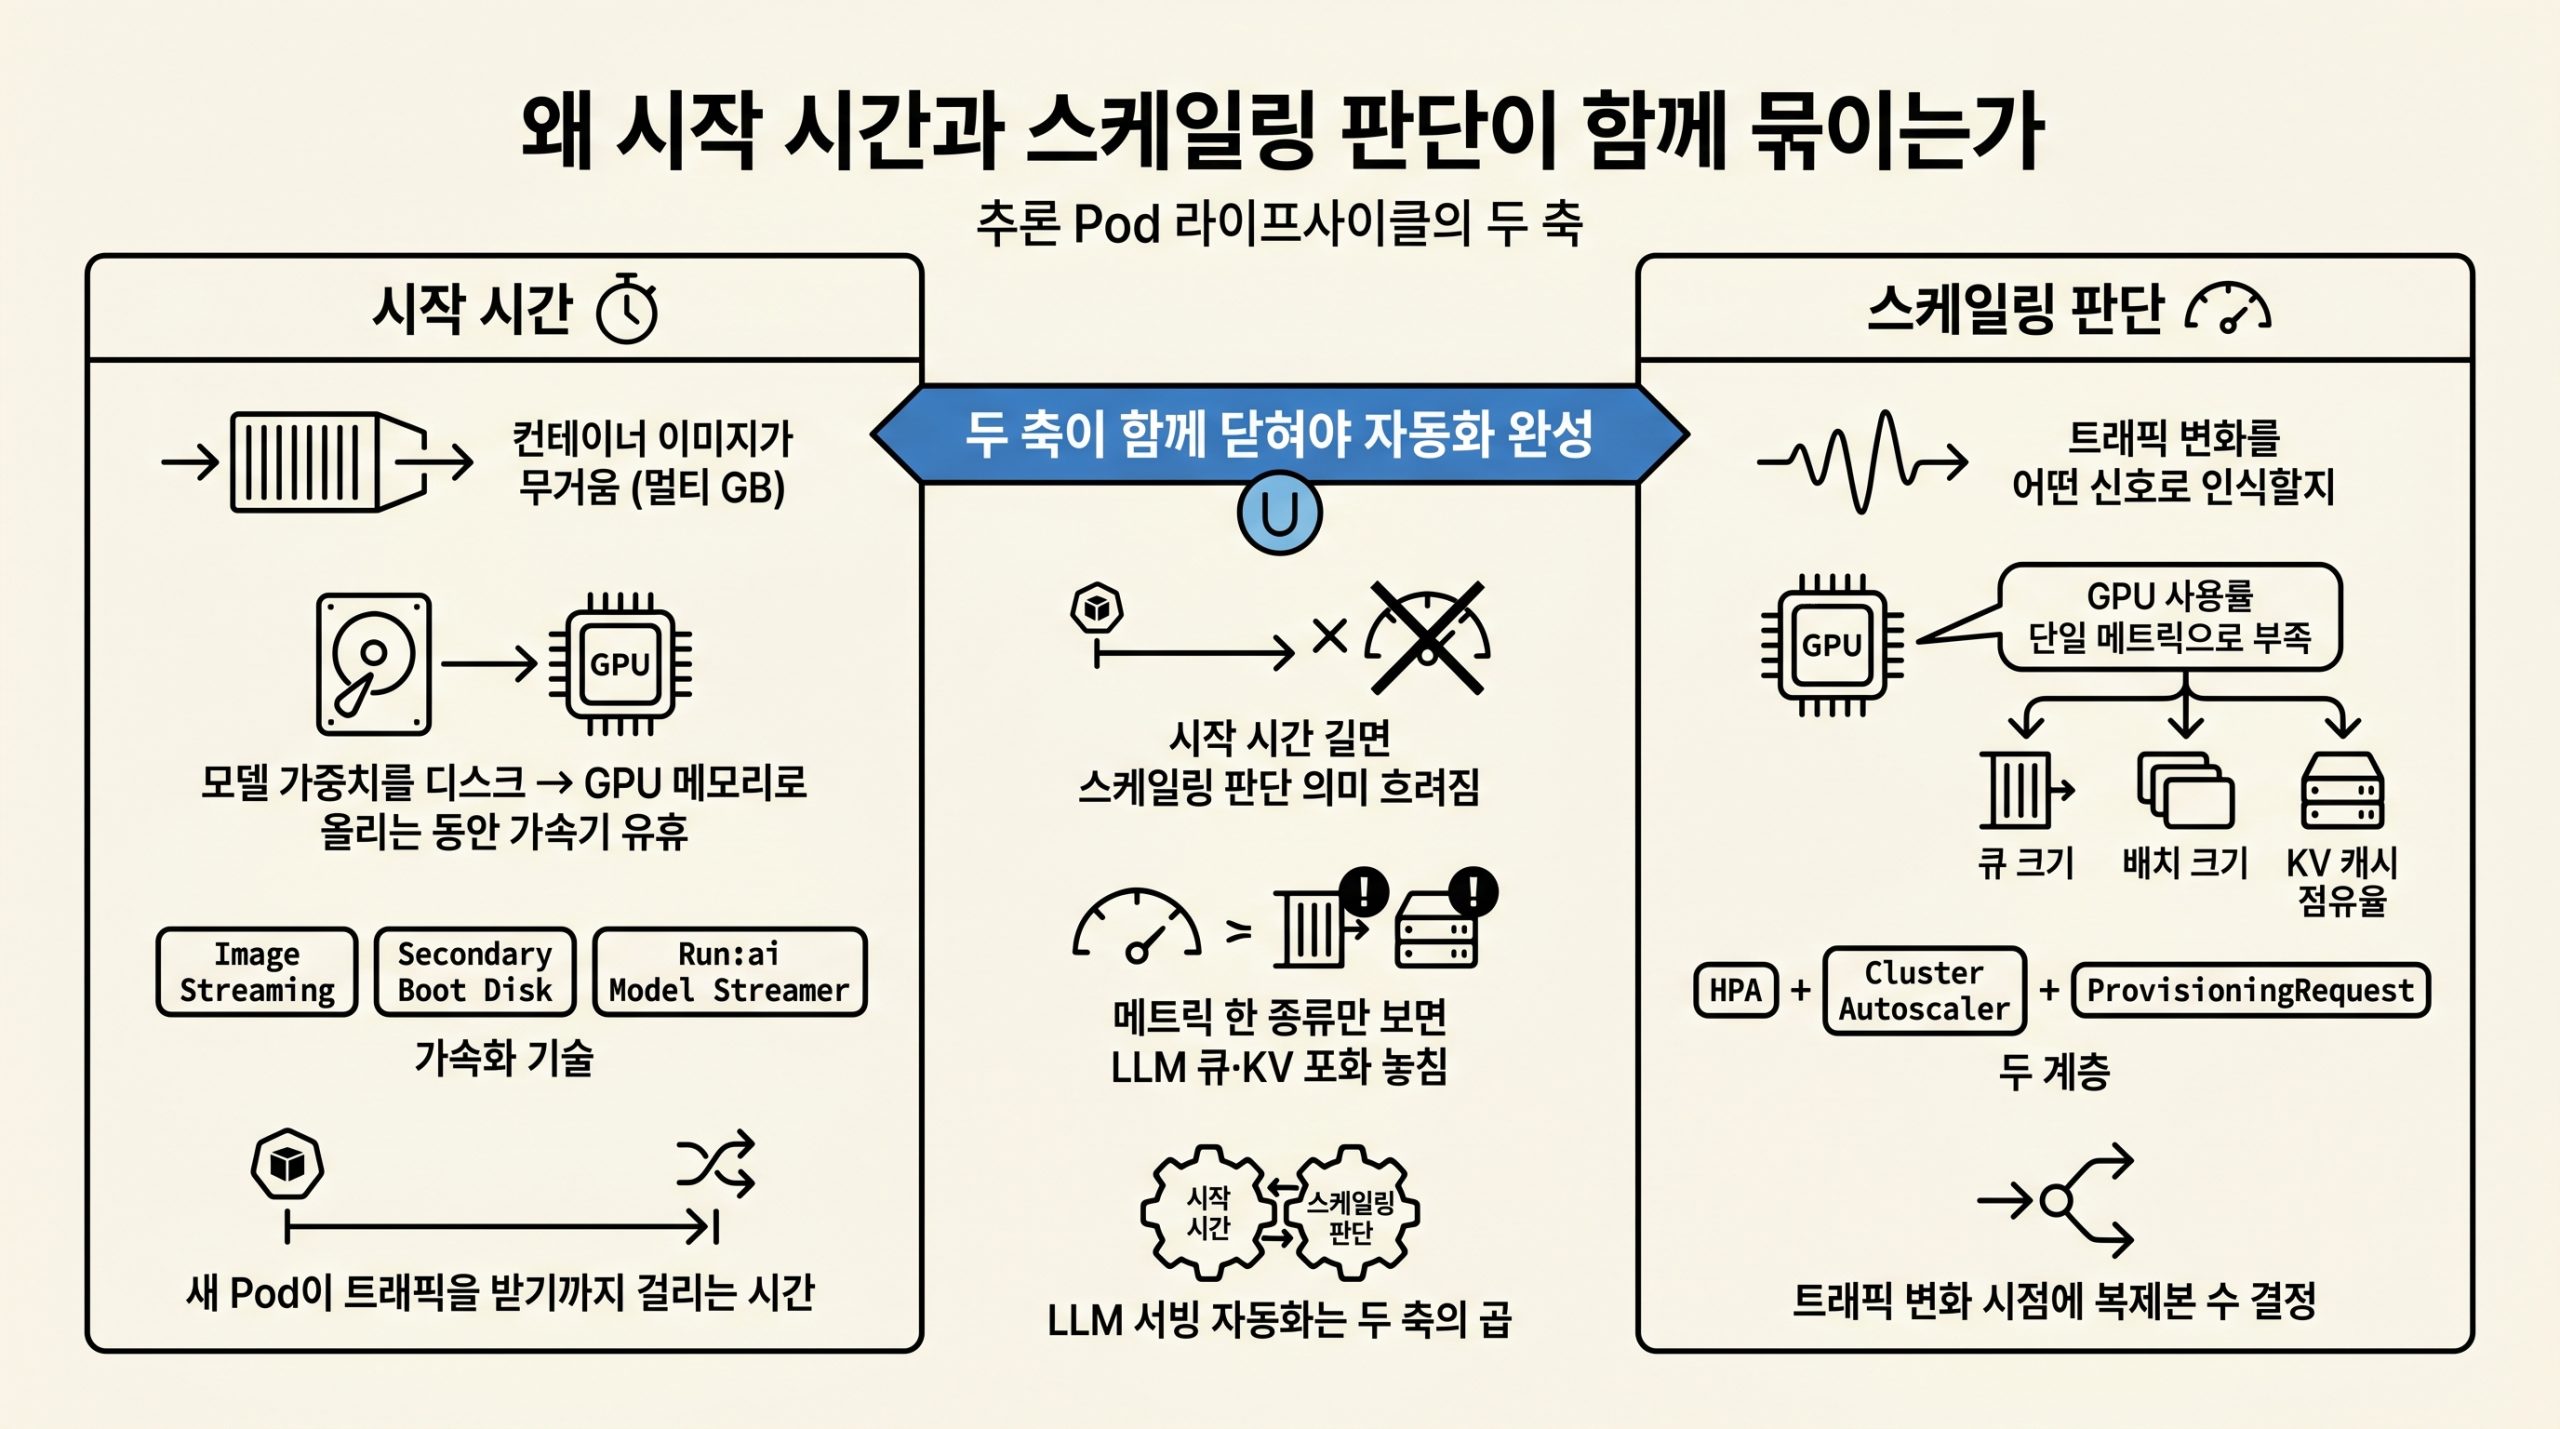
4편: 시작 가속과 의도 기반 오토스케일링 LLM 서빙 Pod의 라이프사이클은 두 시점에서 갈립니다. 새 Pod이 처음 트래픽을 받기까지 걸리는 시간과, 트래픽 변화에 맞춰 복제본 수를 조절하는 판단 시점입니다. 구글 쿠버네티스 엔진(GKE)은 Google Cloud Next 2026에서 이 두 시점을 함께 다루는 기능을 발표했습니다. 컨테이너 이미지와 모델 가중치를 빠르게 끌어오는 시작 가속 기술, 그리고 GPU 사용률 같은…
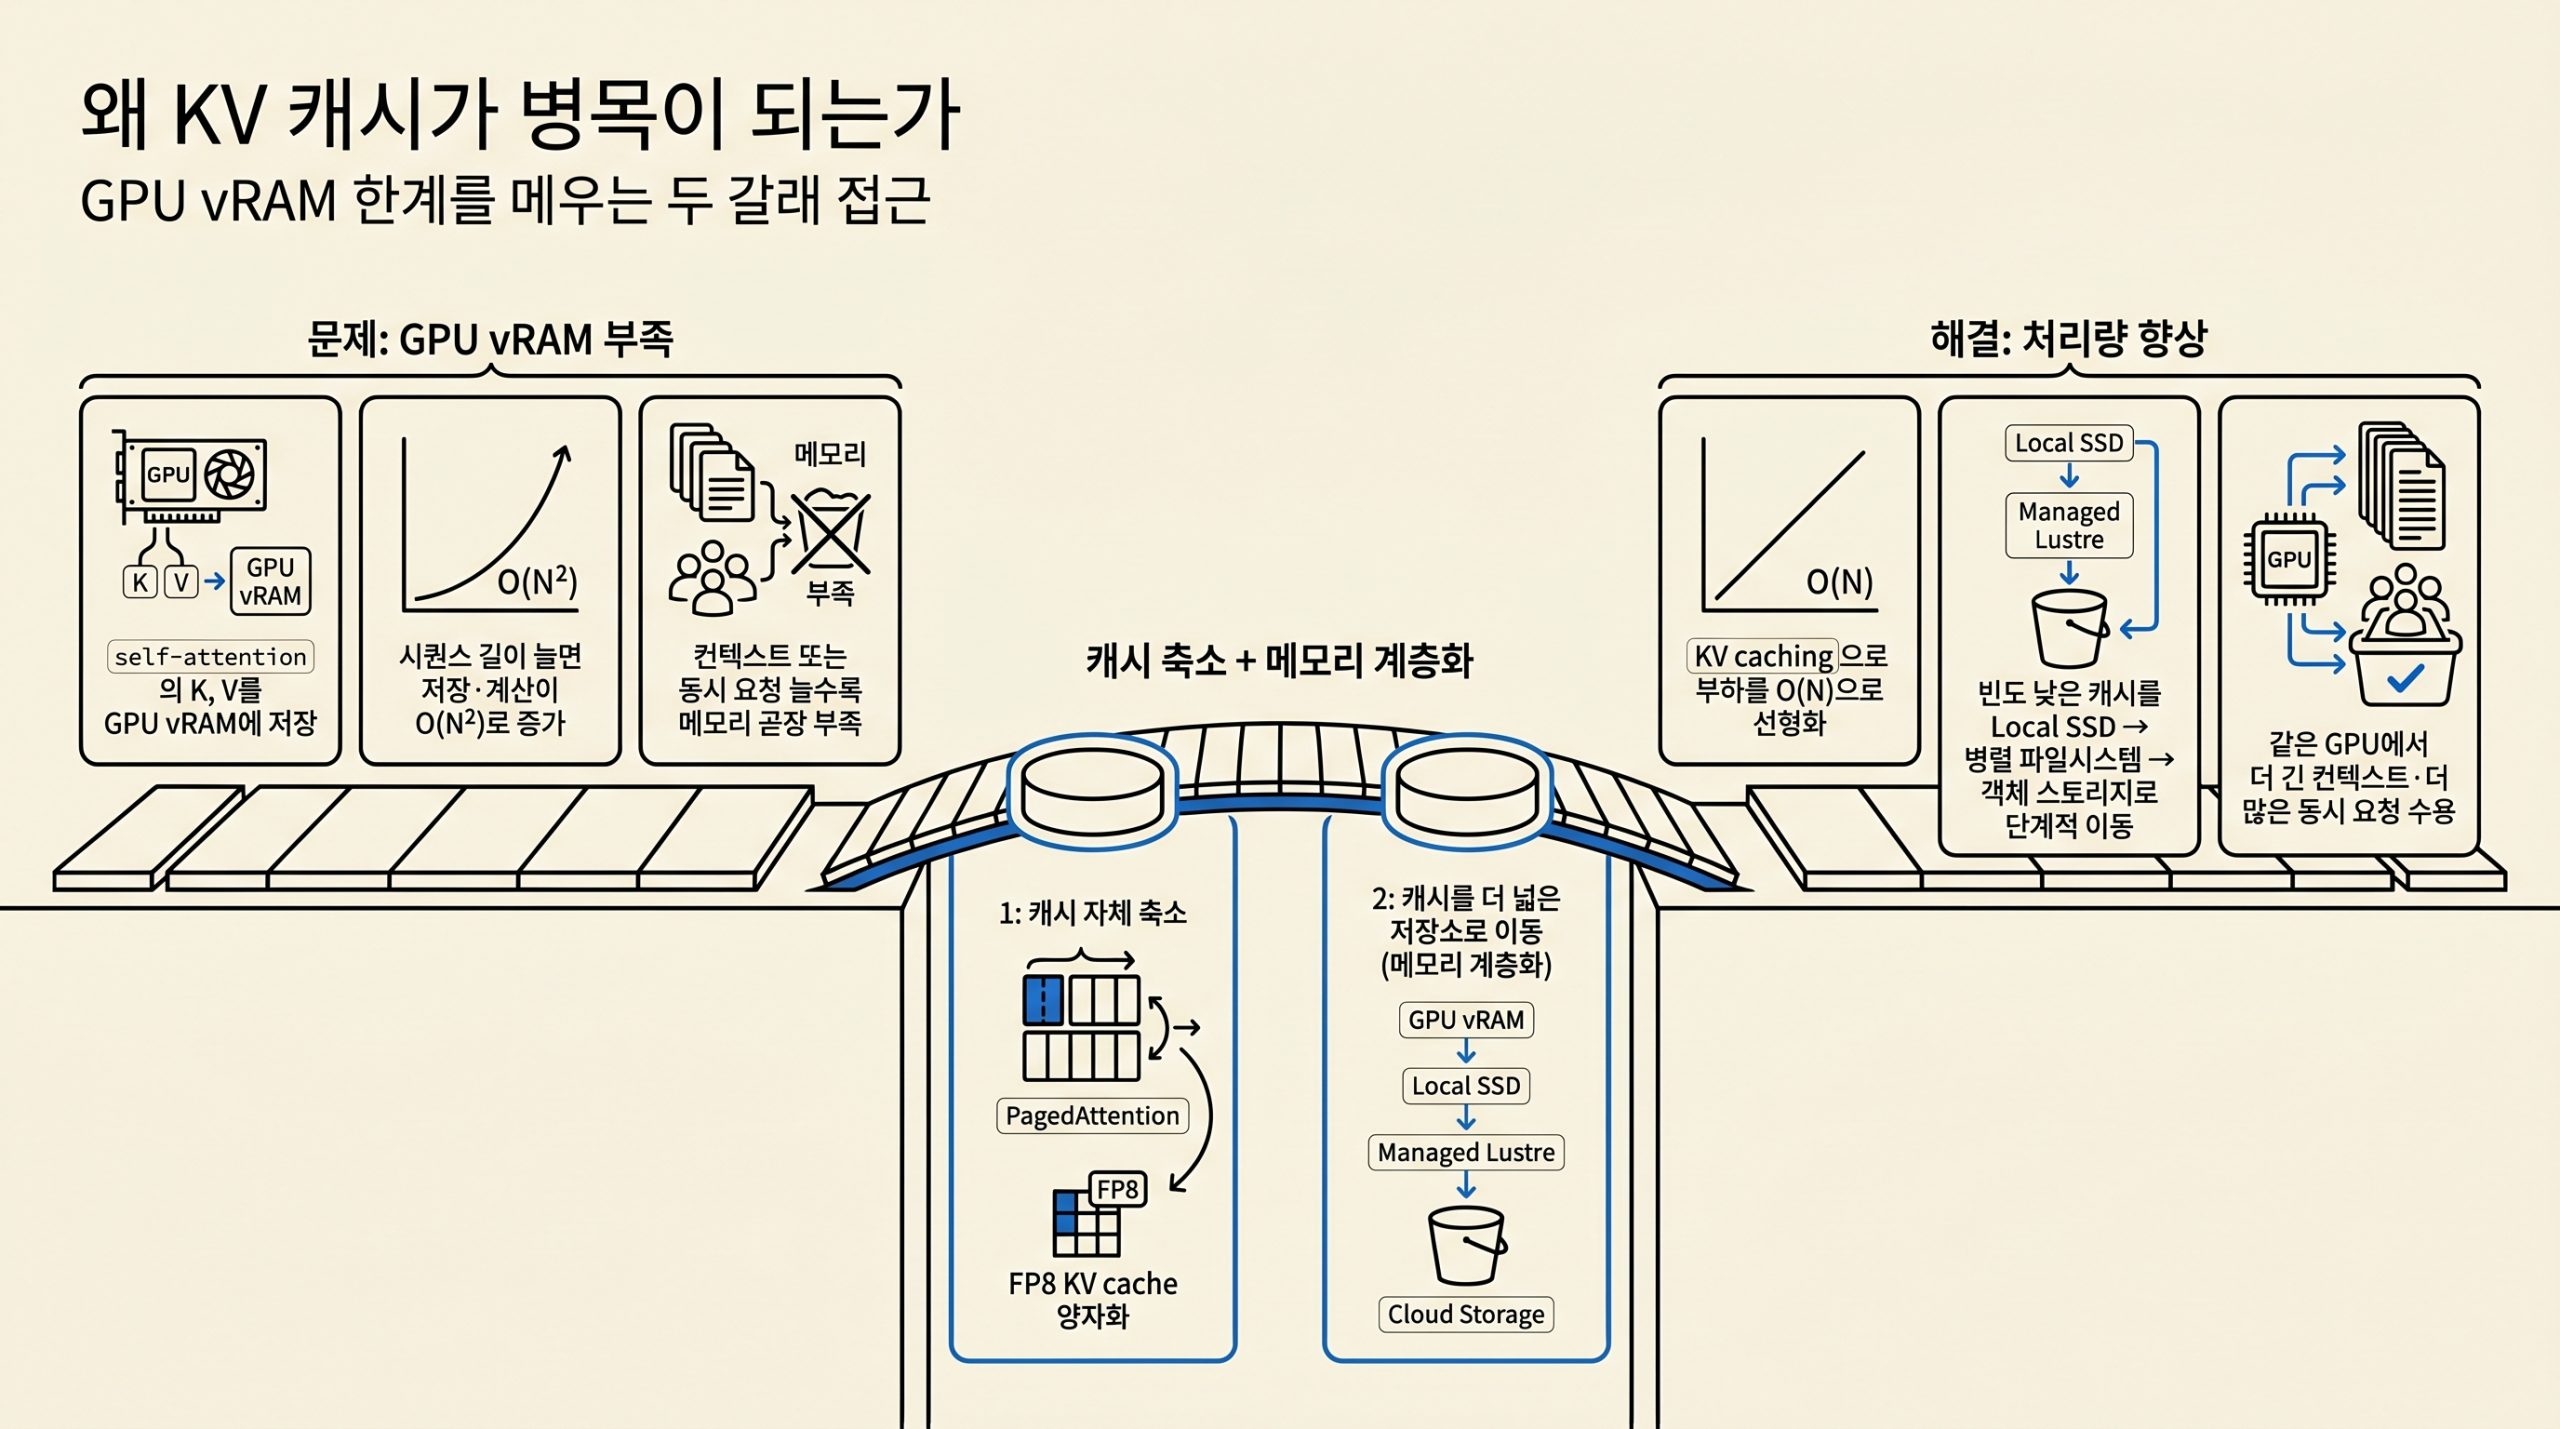
3편: KV 캐시 티어링과 메모리 계층화 키-값 캐시(KV 캐시)는 대규모 언어 모델(LLM) 서빙에서 그래픽 처리 장치(GPU) 메모리를 가장 빠르게 갉아먹는 자원입니다. 입력 시퀀스가 길어질수록 self-attention이 저장하는 키와 값의 크기가 비례해 늘어나고, 같은 GPU에 올릴 수 있는 동시 요청 수는 줄어듭니다. 본 글은 이 KV 캐시를 GPU의 고대역폭 메모리(HBM)에서 하위 저장소로 끌어내려 처리량을 끌어올리는 메모리 계층화…
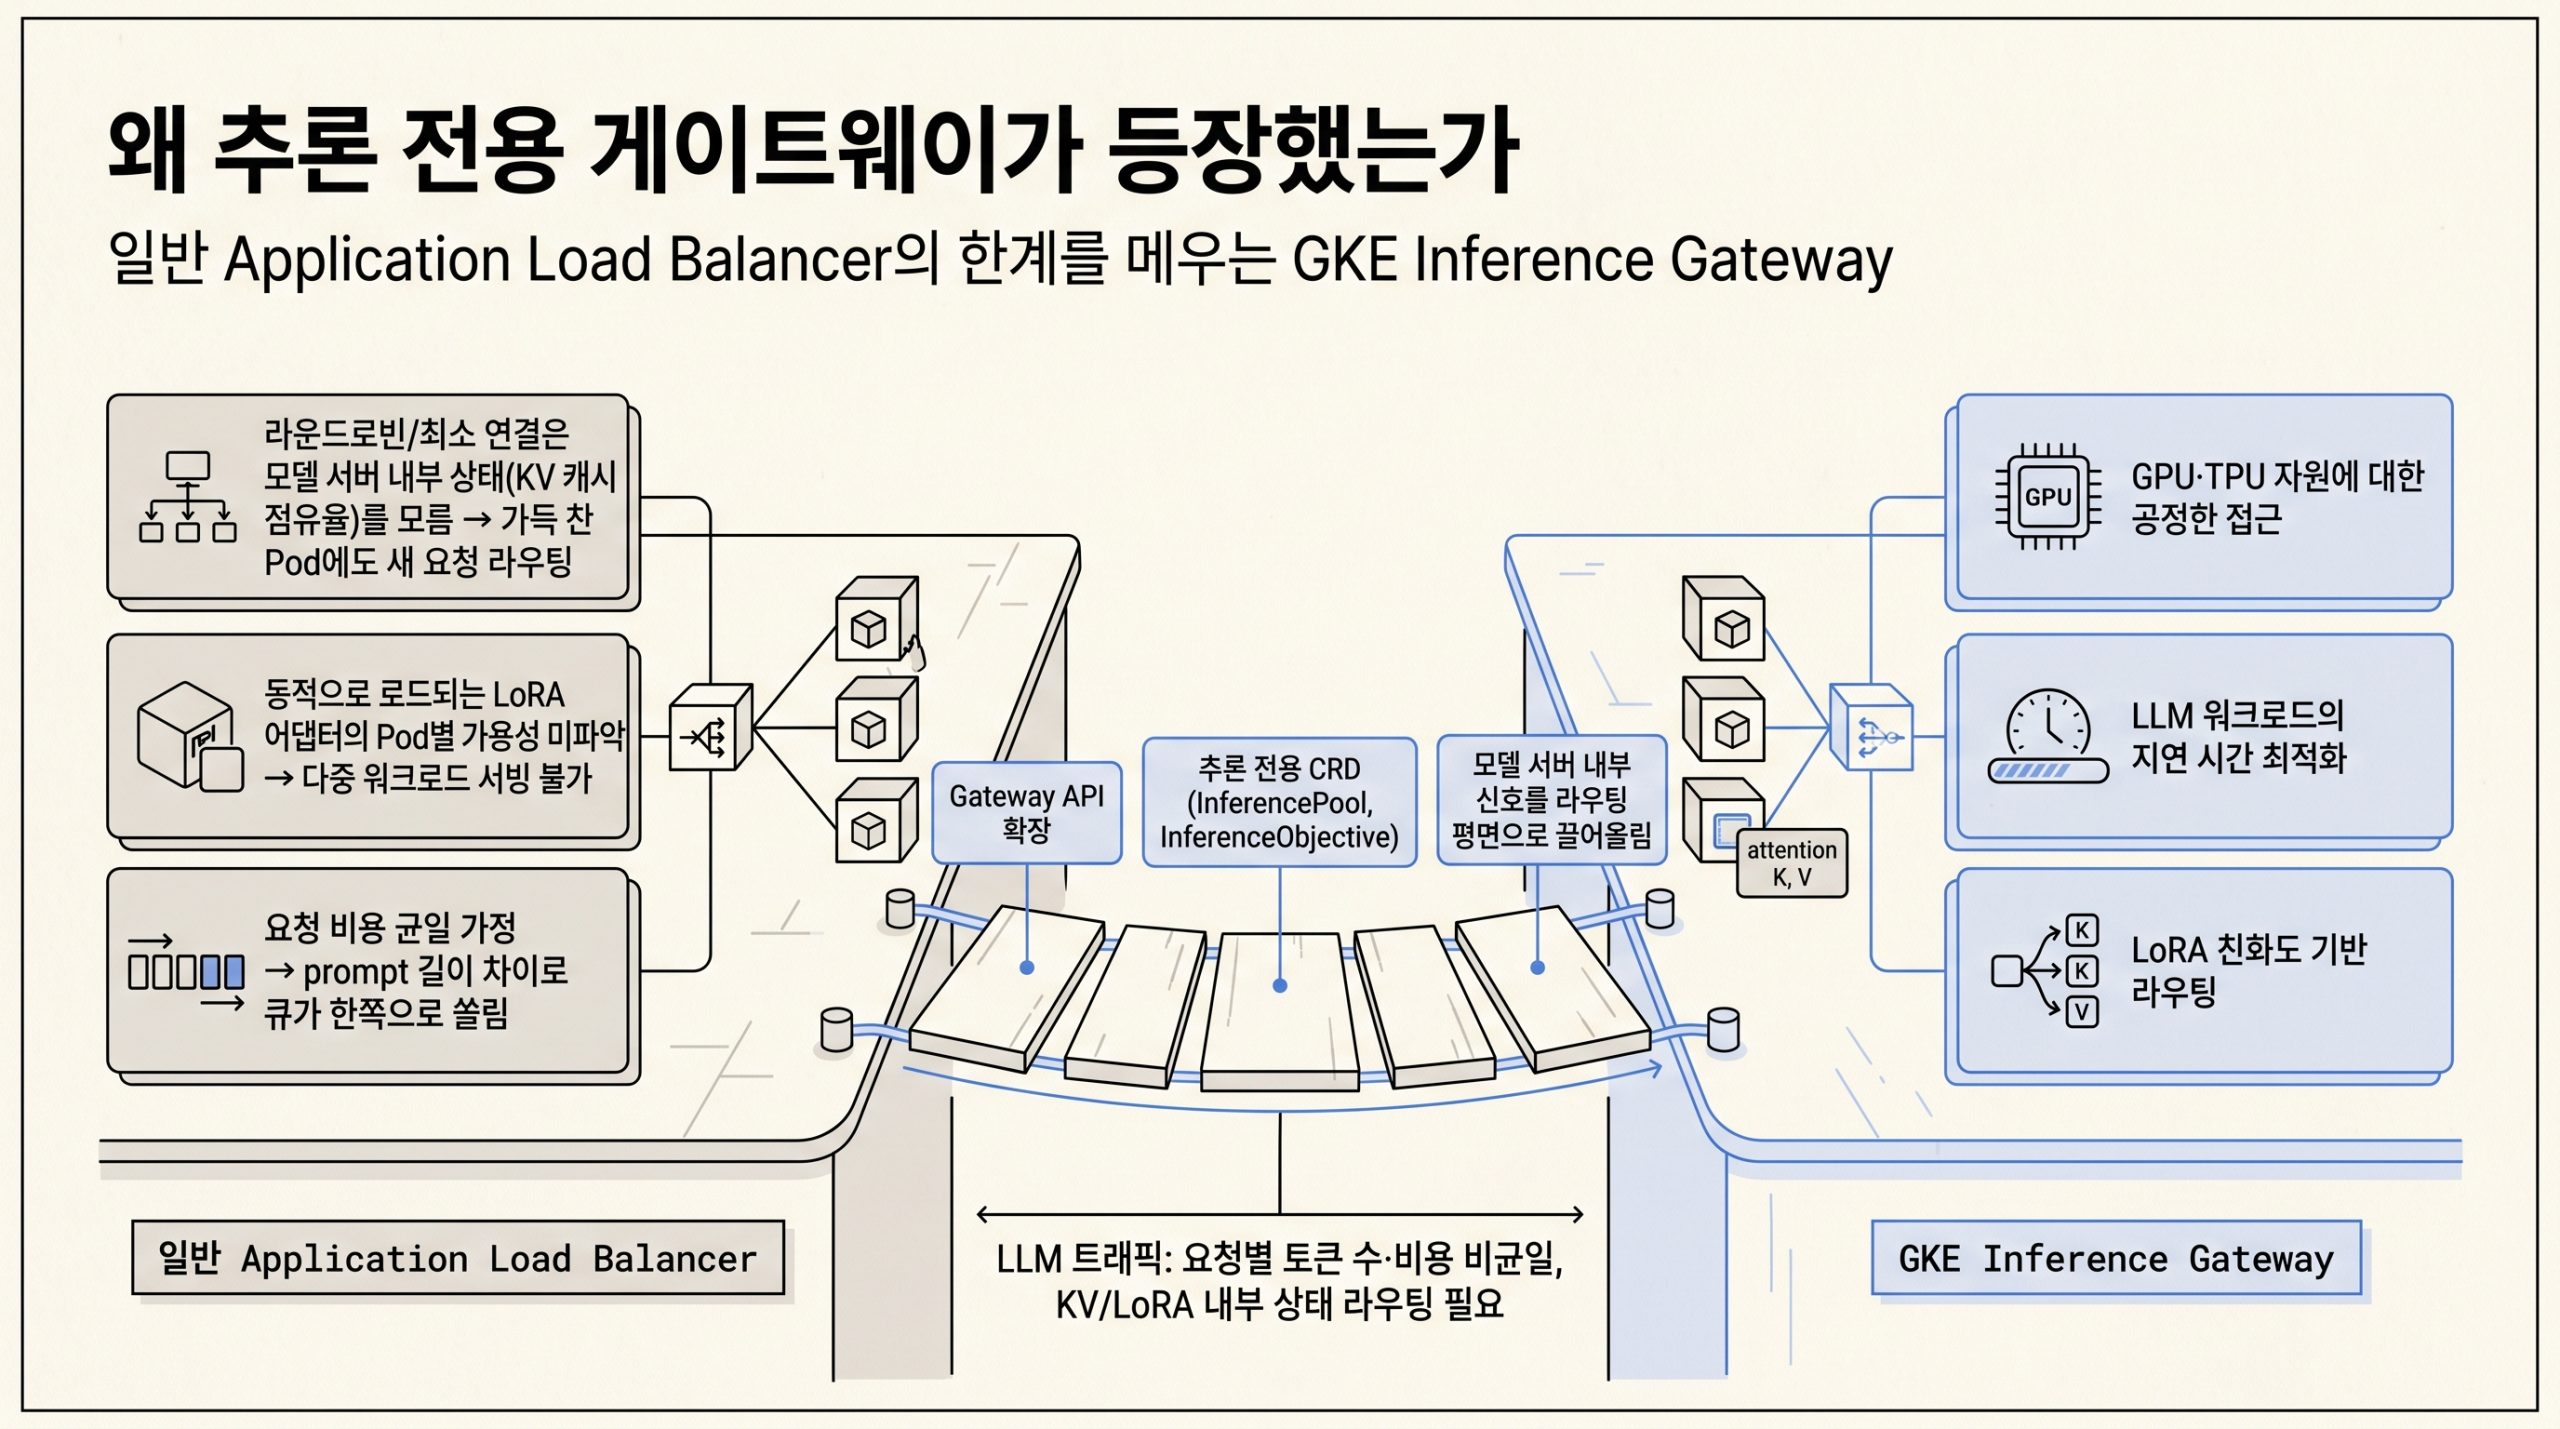
2편: GKE Inference Gateway로 LLM 서빙 표준화 GKE Inference Gateway는 구글 쿠버네티스 엔진(GKE) 위에서 대규모 언어 모델(LLM) 서빙을 표준화하는 추론 최적화 로드밸런서입니다. Google Cloud Next 2026에서 강조된 이 컴포넌트는 vLLM·TGI·JetStream 같은 모델 서버 위에 얹혀, 일반 HTTP 로드밸런서가 보지 못하는 KV 캐시 점유율, 요청 큐 길이, LoRA 어댑터 가용성 같은 추론 고유 신호를 라우팅 결정에…
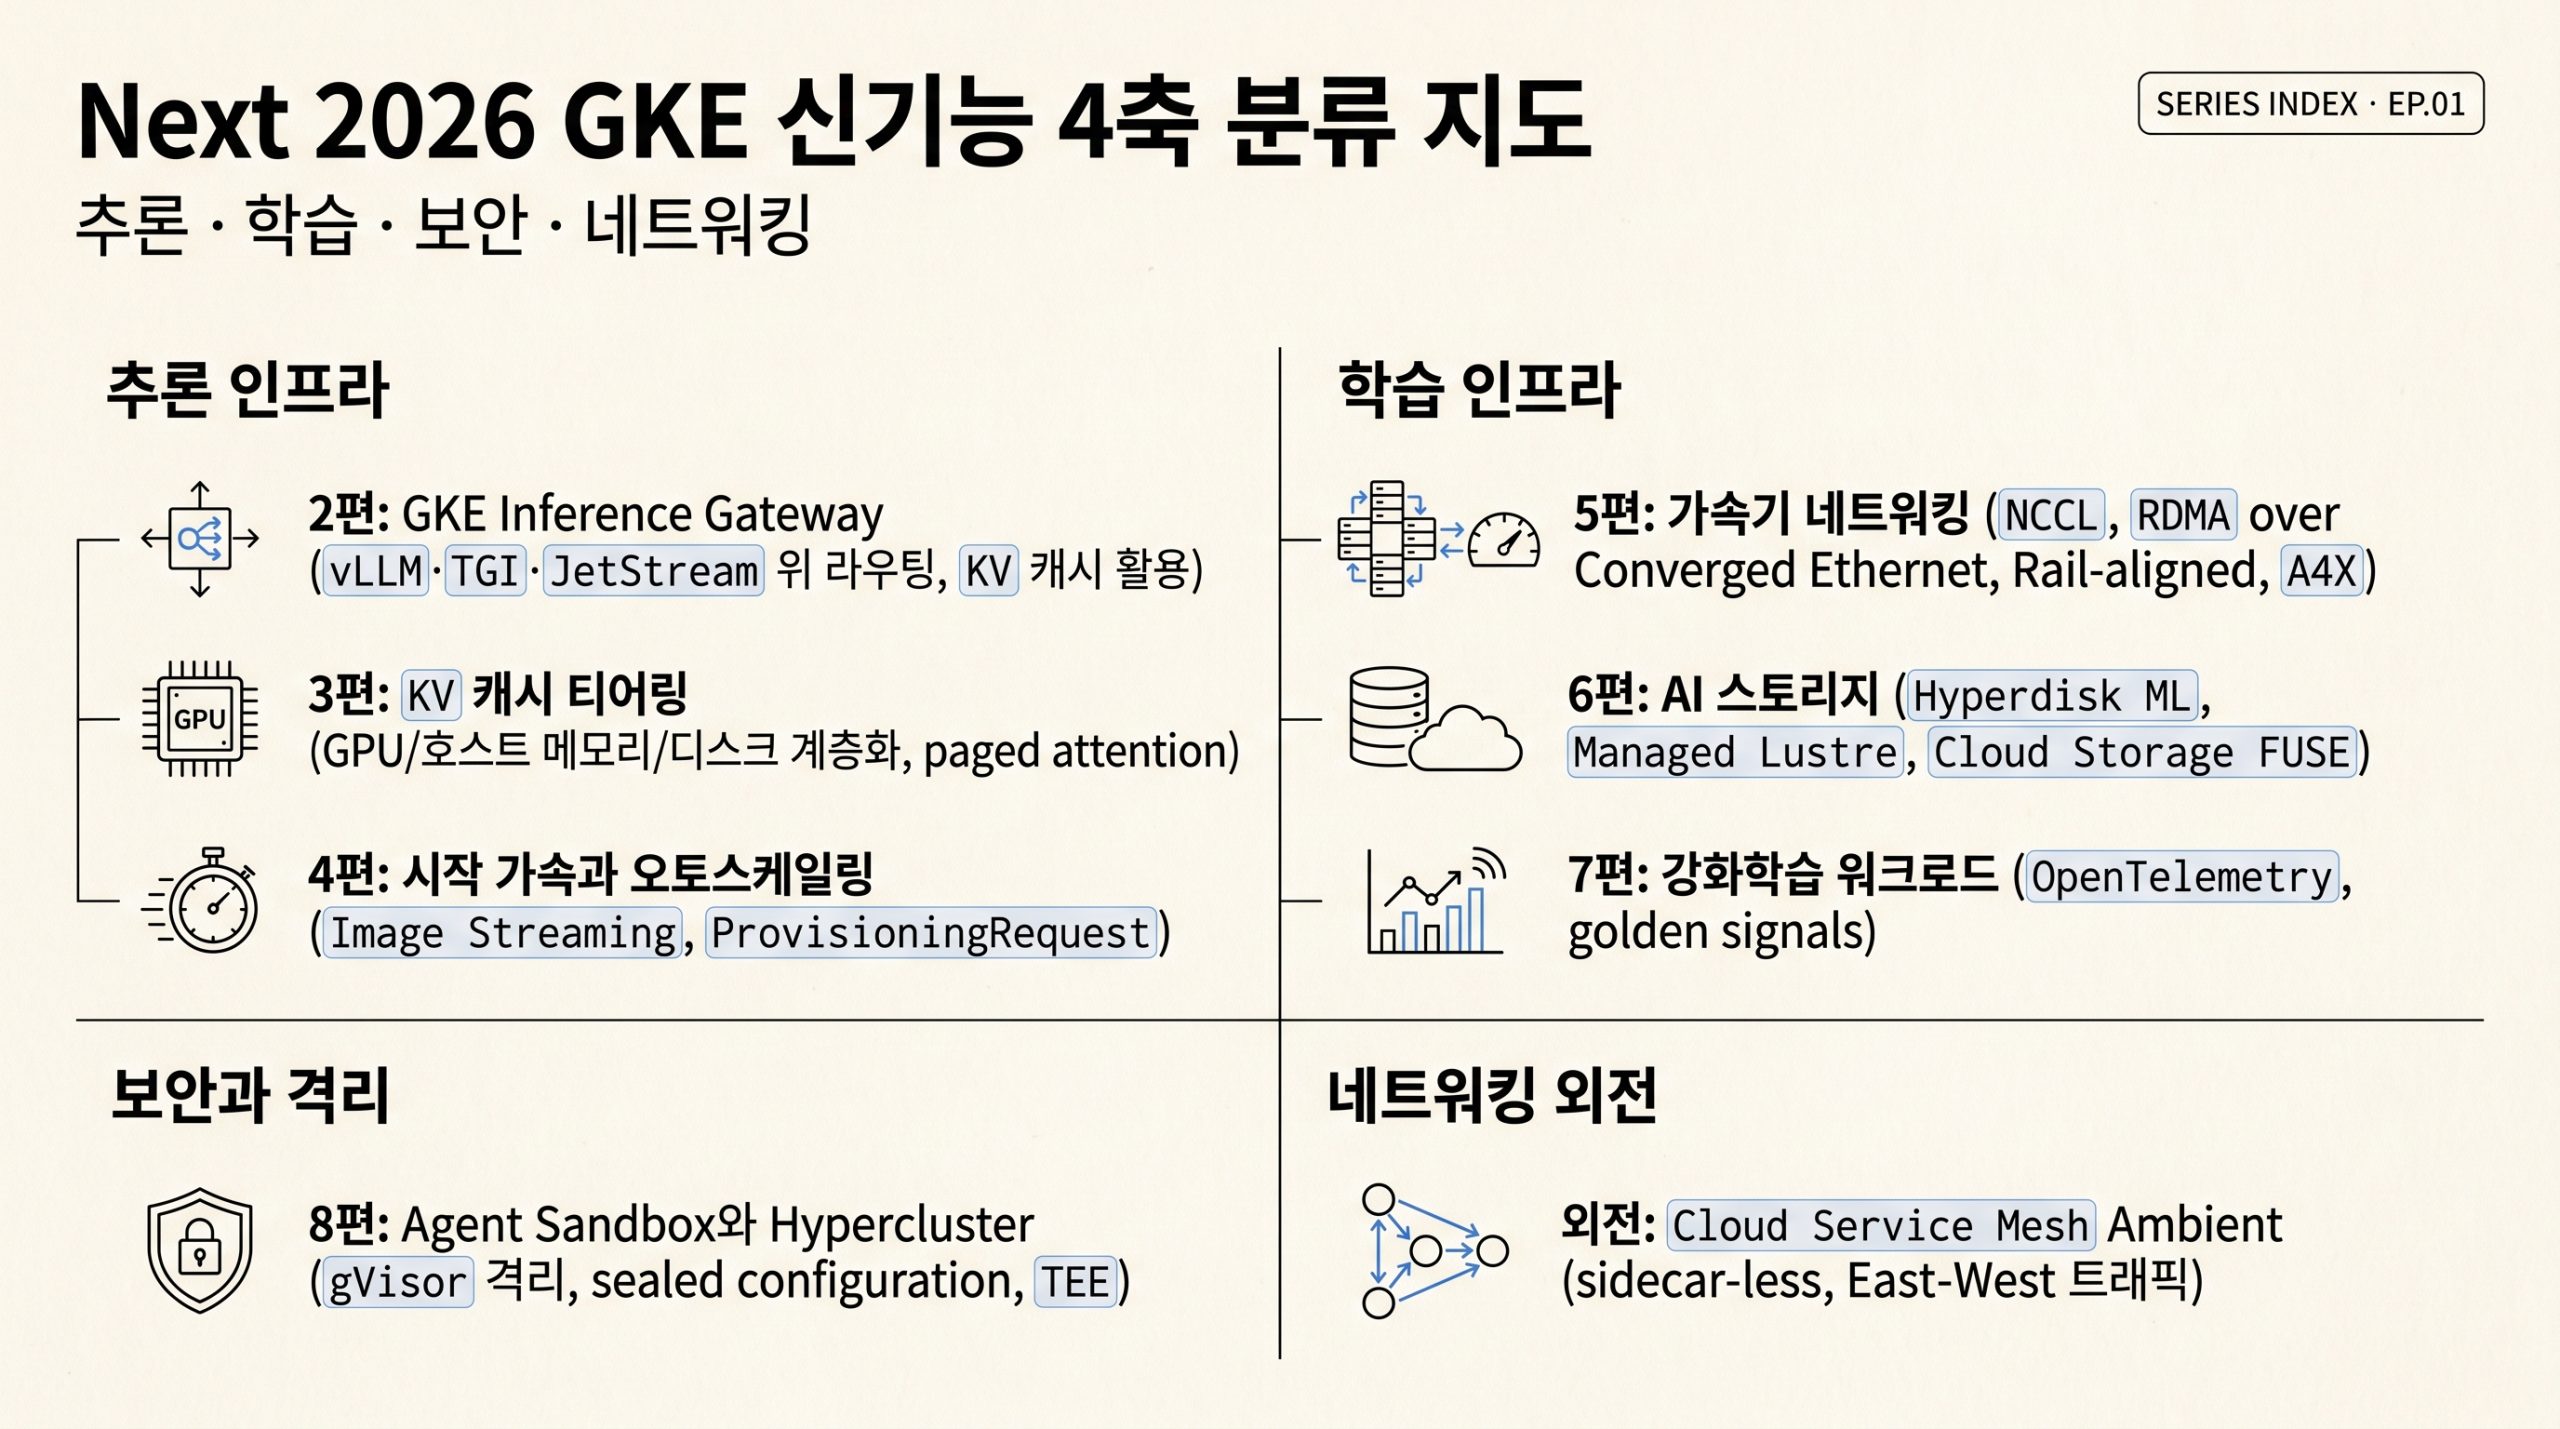
1편 개관: Next 2026 GKE의 큰 그림 Google Cloud Next 2026에서 구글 쿠버네티스 엔진(GKE)은 AI/ML 인프라 자동화를 한 축으로 묶어 발표했습니다. 추론 서빙, 학습 가속, 워크로드 격리, 클러스터 간 통신까지 각 영역에 신기능이 들어왔습니다. 본 글은 시리즈 인덱스로, 이후 본편들이 다룰 신기능 10개를 추론 인프라, 학습 인프라, 보안과 격리, 네트워킹 4축으로 정리합니다. 본편 구성…