기업의 AX 전략은 병목을 풀어 가는 여정에 빗대어 말할 수 있습니다. AI 가속기를 시작으로 CPU, 네트워크, 스토리지 등 병목 구간이 여기저기 많습니다. 이런 이유로 요즘 업계가 주목하는 것이 통합 설계입니다.
AI 인프라를 구성하는 모든 요소를 설계 단계부터 통합을 전제로 구성하고 최적화하는 것이 요즘 흐름인데요. 관련해 이번 포스팅에서는 에이전틱 AI 시대를 위해 병목을 구글 클라우드 인프라는 어떻게 해결하는지 알아보겠습니다.
에이전트 확산의 발목을 인프라가 잡는 이유
몇 년 전만 해도 생성형 AI는 채팅이 중심이었습니다. 질문을 하나 던지면 답을 하나 받았습니다. 에이전트는 많이 다릅니다. 사용자가 원하는 작업 내용을 말하면 여러 에이전트가 움직여 결과물을 내놓습니다. 하나의 질문에 하나의 답이 나가던 것과는 비교할 수 없는 수준으로 모델, 도구, 에이전트 간 상호작용이 일어나는 구조로 바뀐 것이죠. 상황이 달라지다 보니 자연스럽게 인프라 병목이 에이전트 운영의 걸림돌로 떠오르고 있습니다.
인프라 병목은 AI 가속기에만 머물지 않습니다. 에이전트는 도구를 쓰고, 기존 애플리케이션을 호출하고, 기존 데이터에 접근합니다. GPU와 TPU에 부담을 주는 동시에 CPU 컴퓨팅, 스토리지, 네트워크에도 부담을 줍니다. 단일 턴 챗봇에서 멀티 턴 대화로 추론 중심 앱에서 에이전트로 넘어오며 메모리 제약도 커졌습니다. 대화 맥락을 오래 기억하려고 KV 캐시를 유지하니 메모리와 스토리지, 네트워크에 연쇄로 압박이 생깁니다. 자원 사이징도 어려워졌습니다. 예전에는 스토리지나 컴퓨팅을 일정량 사서 몇 년 치 수요를 가늠했습니다. 지금은 수요가 기하급수적으로 늘고 변동도 큽니다.
가속기 확보를 넘어 컴퓨팅 자원을 다시 구성해야 하는 이유
에이전트 워크로드는 대규모 모델 학습, 지연에 민감한 추론, 도구 호출과 오케스트레이션, 기존 업무 시스템 연동 등 성격이 제각각입니다. 이런 특성으로 한 종류의 인프라로 모든 요구를 맞출 수 없습니다. 워크로드별로 맞는 하드웨어와 소프트웨어를 짝지어야 합니다. 구글 클라우드 환경에서는 워크로드 특성에 맞는 조합을 어떻게 짤 수 있을까요?
구글 클라우드는 폭넓은 하드웨어 선택권을 제공합니다. 사용자는 NVIDIA GPU와 구글의 TPU를 워크로드에 맞게 섞어 쓸 수 있습니다. 특히 TPU 선택지를 주목할만 한데요. Next ’26에서 공개한 8세대 TPU는 이 방향을 잘 보여 줍니다. 학습용 TPU 8t와 추론·강화 학습용 TPU 8i로 역할을 나눴습니다. 구글 클라우드에 따르면 TPU 8i는 이전 세대보다 추론 가격 대비 성능이 80% 좋아졌습니다.
CPU 옵션도 다양합니다. 에이전트가 도구와 애플리케이션을 호출하고 오케스트레이션하는 일은 CPU가 맡습니다. 인텔과 AMD의 x86 CPU, 구글의 Arm 기반 Axion CPU까지 다양한 Compute Engine 인스턴스가 필요한 이유입니다. 참고로 구글 클라우드는 Axion N4A VM이 GKE의 에이전트 워크로드에서 30% 나은 가격 대비 성능을 낸다고 밝혔습니다.
하드웨어를 여러 종류 갖춰도 워크로드에 맞게 옮겨 쓰지 못하면 효과가 없습니다. 구글 클라우드는 GKE의 커스텀 컴퓨트 클래스(Custom Compute Classes)를 통해 유연한 자원 재배치도 지원합니다. 예를 들어 어떤 워크로드를 GPU에서 먼저 서빙하다가 수요가 늘어 GPU만으로 부족하면 TPU로 넘겨 확장하도록 우선순위를 정할 수 있습니다. 반대 방향도 가능합니다. 가속기 수급이 빠듯한 현재 상황을 고려할 때 할당 가능한 자원을 끝까지 찾아 쓰는 구조는 매우 중요하다 할 수 있습니다.
GKE 자체도 에이전트 워크로드에 맞게 빨라지고 있습니다. 구글 클라우드는 Next ’26에서 노드 시작 속도 4배 향상, 파드 시작 시간 최대 80% 단축, 모델 로딩 5배 향상을 발표했습니다. AI 기반 Inference Gateway는 첫 토큰까지 걸리는 시간(TTFT)을 70% 넘게 줄였습니다.
xPU 환경에서 호환성을 확보하는 방법
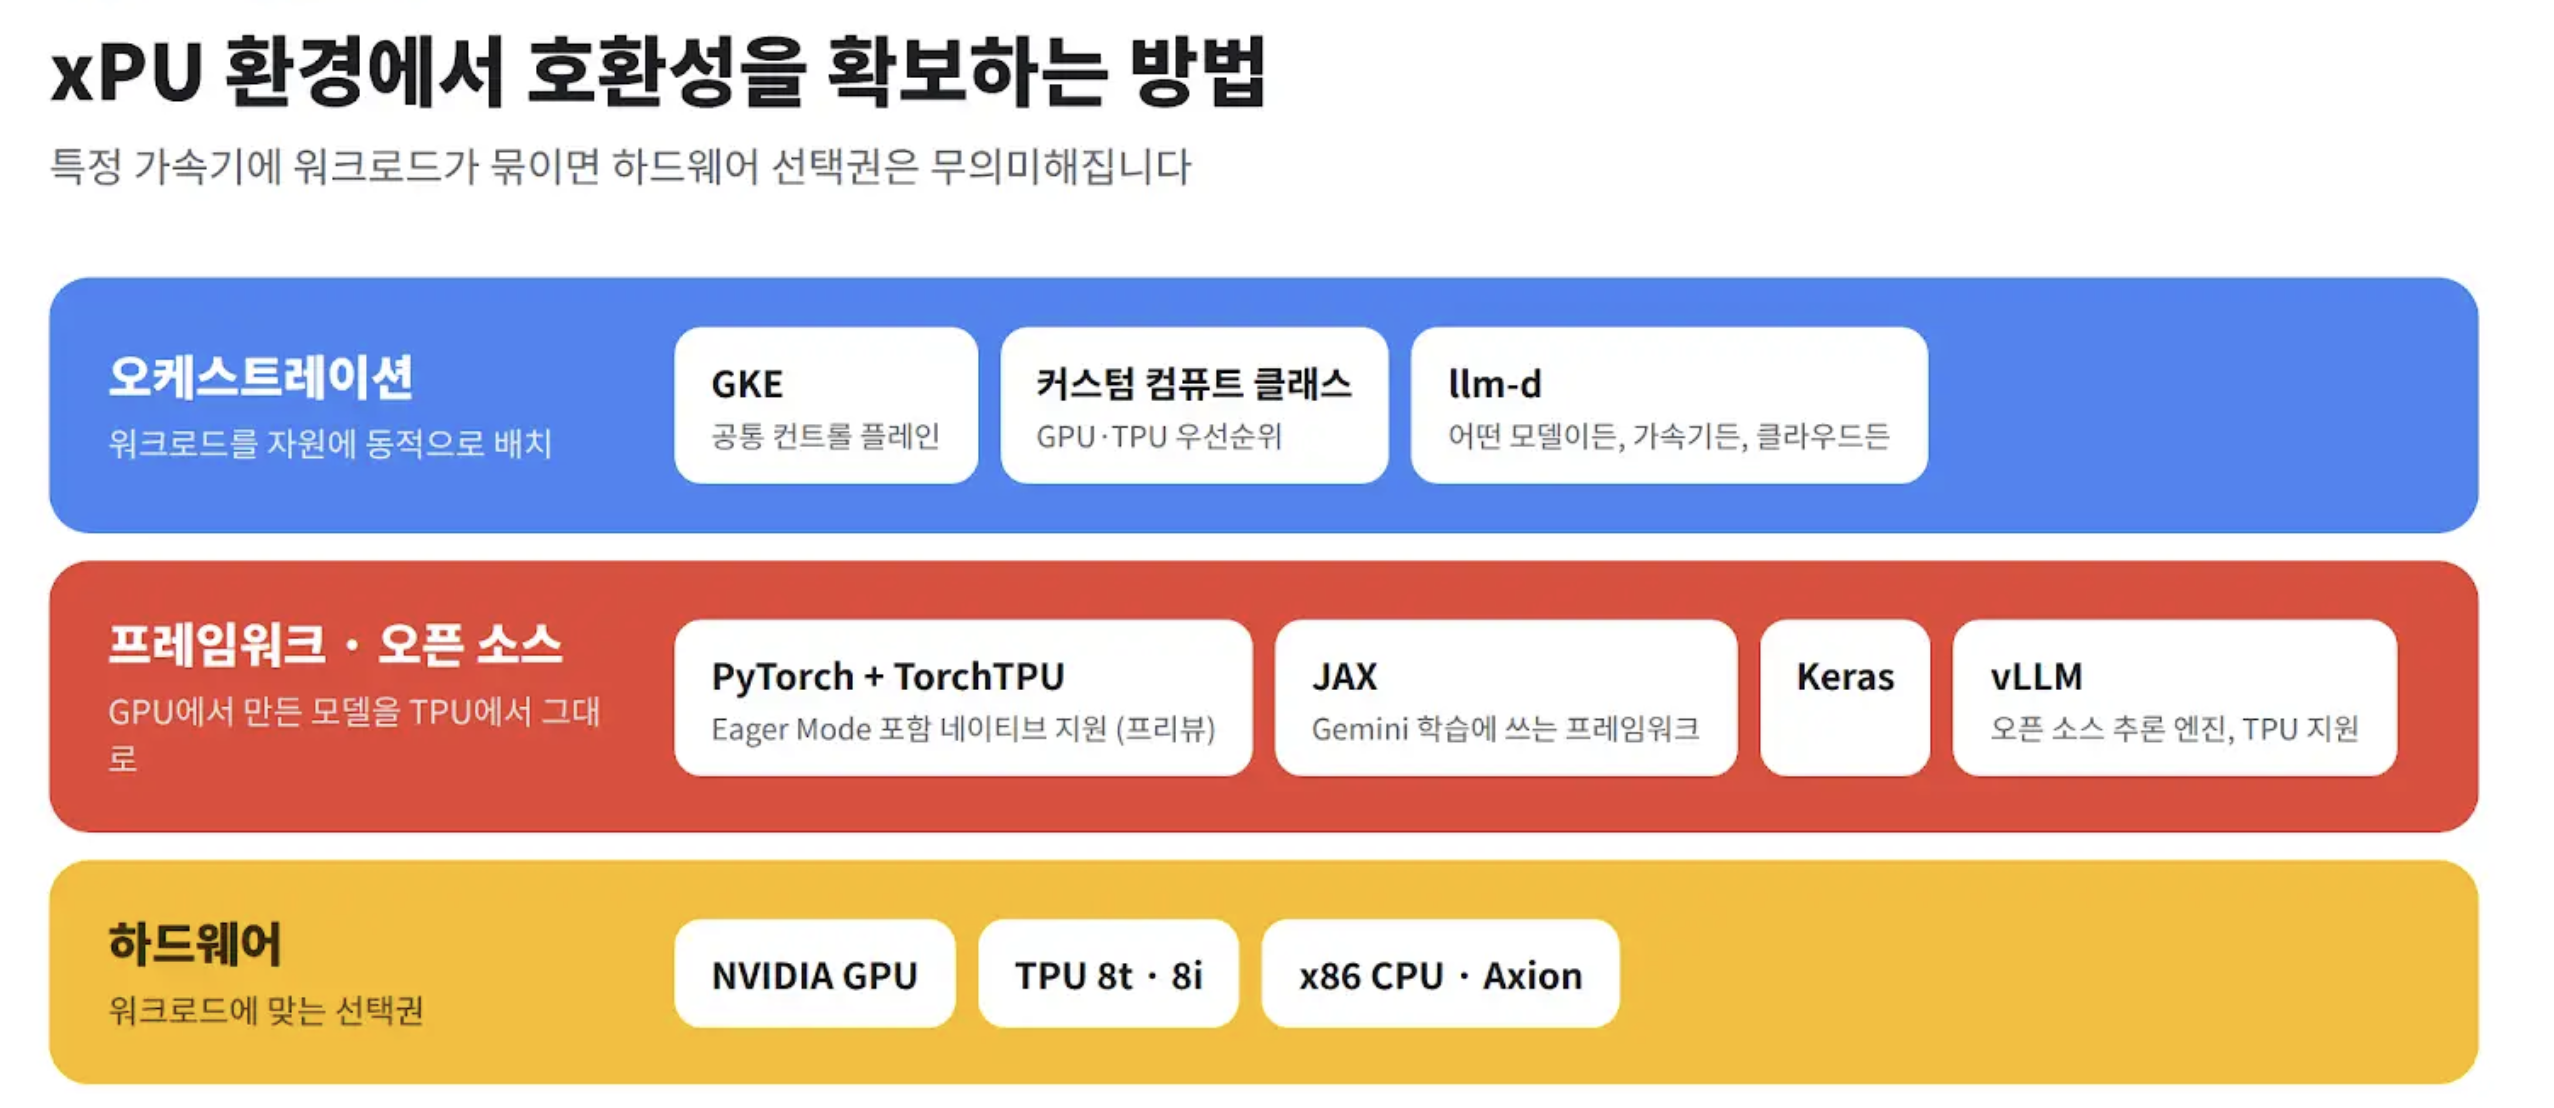
하드웨어 선택지가 넓다고 워크로드 유형에 딱맞게 자원을 활용할 수 있는 것은 아닙니다. 특정 가속기에 워크로드가 묶이면 선택권이 무의미해집니다. GPU에서 최적화한 모델을 TPU에서 그대로 돌릴 수 있어야 합니다. 구글 클라우드는 두 가지 방법으로 이 문제를 풉니다.
하나는 검증된 프레임워크를 활용하는 방법입니다. PyTorch는 GPU 생태계에서 가장 널리 쓰는 프레임워크입니다. 구글은 TorchTPU로 TPU에서 PyTorch를 네이티브로 지원합니다. Eager Mode를 포함한 PyTorch 기본 기능을 그대로 쓰고 모델을 수정하지 않고 TPU에서 실행합니다. 참고로 TorchTPU는 현재 일부 고객 대상 프리뷰로 제공합니다. 구글 내부에서 개발해 Gemini 학습에 쓰는 JAX도 외부에 공개했습니다. Keras 지원도 이어집니다.
다른 하나는 오픈 소스를 활용하는 방법입니다. 에이전트 시대에는 추론 엔진이 특히 중요합니다. GPU 환경에서 인기가 높은 오픈 소스 추론 엔진 vLLM을 구글은 TPU에서도 잘 돌아가도록 지원합니다. 쿠버네티스 기반 분산 추론 프로젝트 llm-d도 ‘어떤 모델이든, 어떤 가속기든, 어떤 클라우드든’을 핵심 가치로 내걸고 있습니다. 구글은 쿠버네티스 초기부터 오픈 소스에 투자해 왔고 이 투자가 xPU 간 이식성의 바탕이 됩니다.
클라우드 네이티브에서 에이전트 네이티브로
클라우드 네이티브가 애플리케이션을 컨테이너와 API, 자동화된 운영 단위로 바꿨다면 에이전트 네이티브는 인프라를 지능형 작업 단위로 다시 보게 합니다. 요청 수만 계산해서는 부족합니다. 한 에이전트 실행이 몇 개의 모델과 도구를 호출하는지, 얼마의 메 모리와 캐시를 쓰는지, 어느 단계에서 사람이 개입하는지를 함께 봐야 합니다.
구글 클라우드를 활용할 때도 서비스 목록부터 고르기보다 워크로드 지도를 먼저 그리는 것이 좋습니다. 온라인·배치·학습·실시간 작업을 나누고 각 작업의 서비스 수준과 비용 상한을 정한 뒤 TPU, GPU, CPU와 관리형 서비스를 배치해야 합니다. 공통 컨트롤 플레인은 GKE로 가져가되 모든 것을 직접 운영하지 않고 Gemini Enterprise Agent Platform(구 Vertex AI), Cloud Run, 관리형 데이터 서비스를 필요한 지점에 조합할 수 있습니다.
가속기를 확보하는 일은 출발점일 뿐입니다. 모델과 트래픽 특성에 맞춘 xPU 검증, GKE 노드 풀과 스케줄링, 데이터·네트워크 경로, 관측과 비용 정책이 함께 움직여야 합니다. 가속기가 기다리지 않는 시스템을 만들고 에이전틱 AI를 파일럿에서 실제 프로덕션 환경으로 옮기고 싶다면 메가존소프트 문의 포털을 통해 상담을 남겨 주세요.