음성 통화(Voicebot) 특화 엔지니어링: 침묵 3진 아웃, Double-Text 방지, 초저지연 오디오 스트리밍
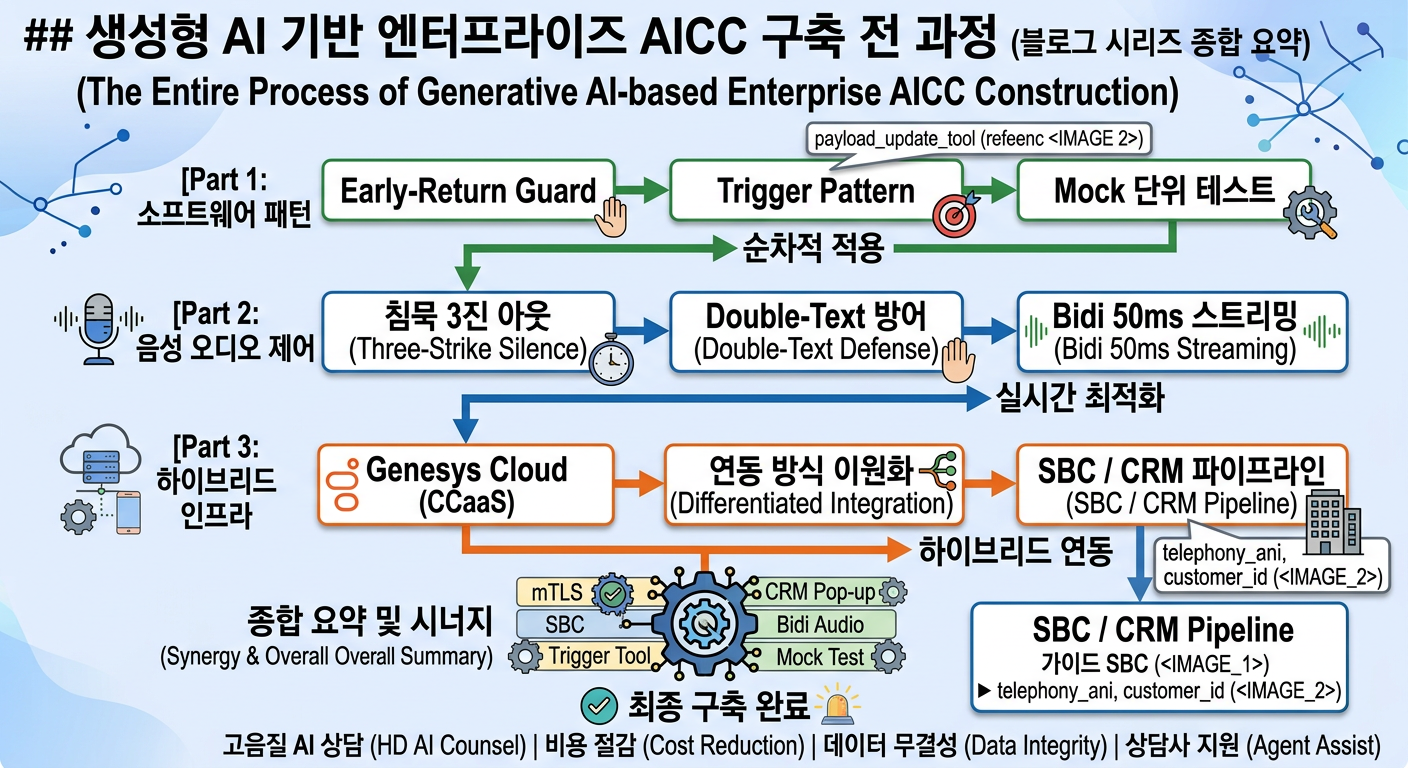
지난 1편에서는 세션 상태의 불변성을 지키는 Early-Return Guard와 LLM의 실행 비결정성을 원천 차단하는 Trigger Pattern을 다루었습니다.
하지만 소프트웨어 아키텍처 레벨에서 비즈니스 로직의 결정론을 확보했더라도, 대상 채널이 텍스트 채팅창에서 실시간 음성 전화망(Voicebot/Callbot)으로 넘어가는 순간 엔지니어는 완전히 새로운 차원의 복잡성에 직면하게 됩니다.
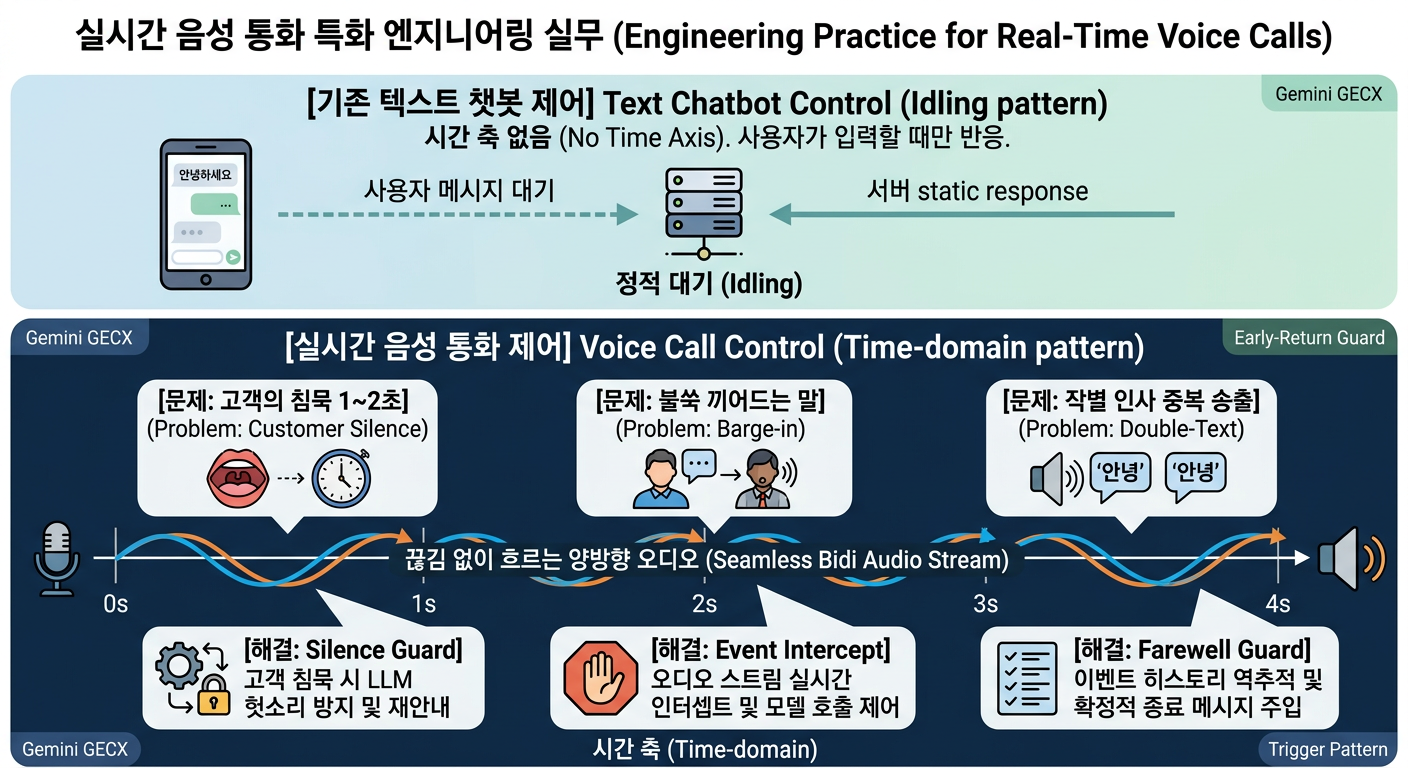
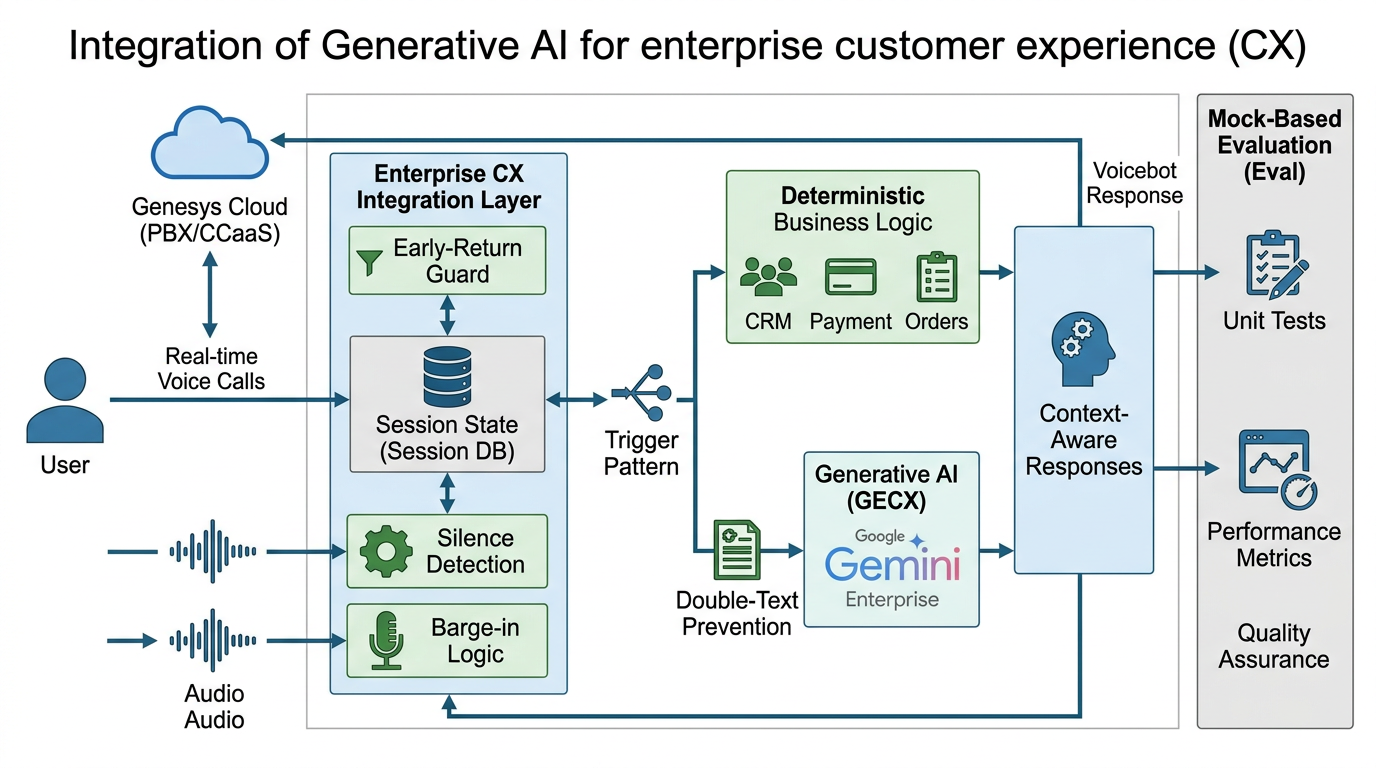
텍스트 챗봇은 사용자가 메시지를 보낼 때까지 서버가 정적으로 대기(Idling)하면 그만입니다. 그러나 전화 통화는 시간 축(Time-domain) 위에서 끊김 없이 흐르는 양방향 오디오 스트림입니다. 고객의 1~2초간의 침묵, 통화 중 불쑥 끼어드는 말(Barge-in), 한 턴 안에서 여러 번 발생하는 모델 호출(Multi-Model Call) 등은 기존 텍스트 프롬프트 지시문만으로는 결코 제어할 수 없습니다.
이번 2편에서는 Google Cloud GECX(Gemini Enterprise for Customer Experience) 런타임에서 음성 통화 특유의 제약을 백엔드 코드로 극복하는 음성 통화 특화 엔지니어링 실무 패턴을 심층 분석합니다.
1. 문제의식: 텍스트 챗봇과 보이스봇의 결정적 차이
음성 통화 환경에서 엔지니어가 마주하는 가장 흔하고 치명적인 장애 시나리오는 크게 3가지입니다.
1.1 침묵(Silence)에 대한 LLM의 환각과 방치
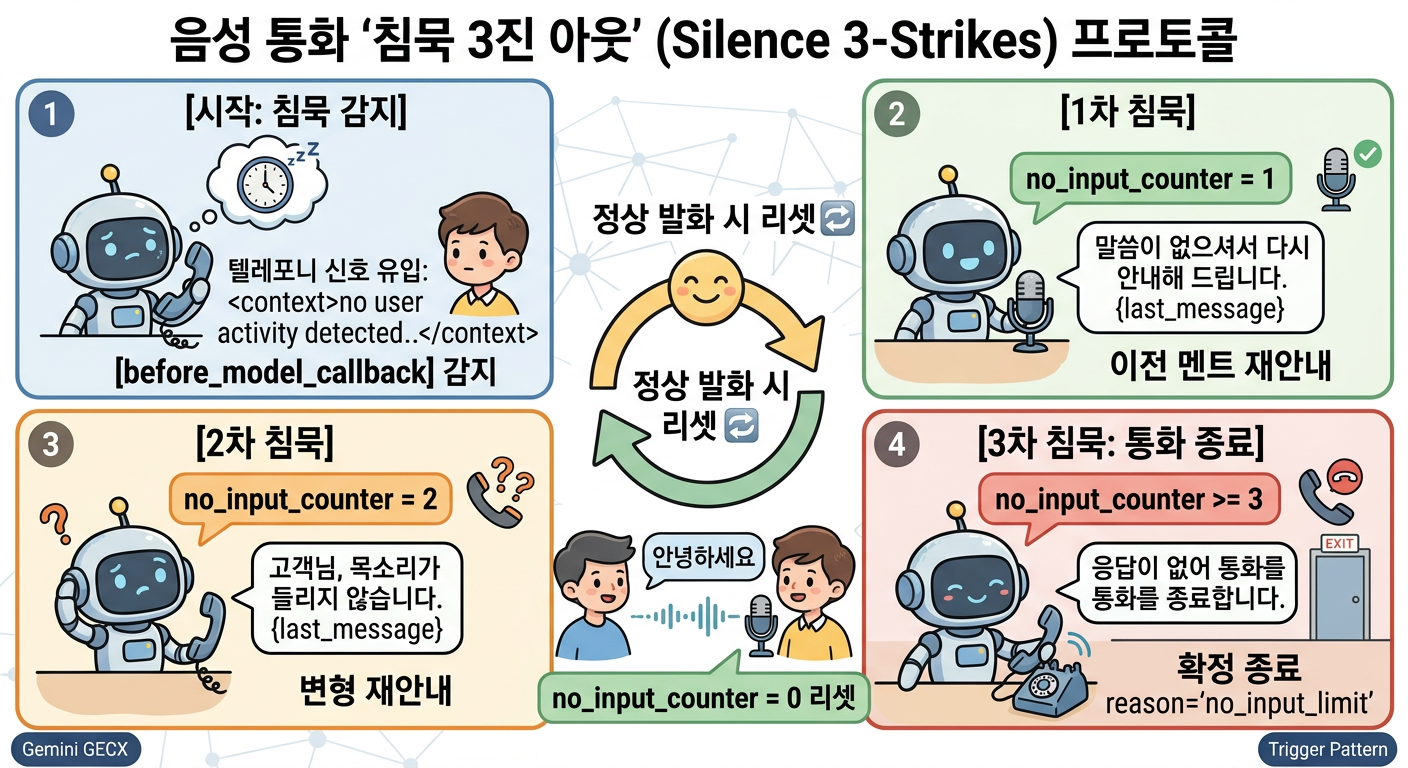
전화 상담 중 고객이 주변 소음을 듣거나 잠시 생각에 잠겨 말을 하지 않을 때, 텔레포니 플랫폼(교환기)은 음성 입력 대신 시스템 이벤트 메타데이터를 보냅니다.
<context>no user activity detected for 8 seconds.</context>
이 텍스트를 그대로 LLM에게 전달하면 모델은 맥락을 오판하여 엉뚱한 가상의 답변을 지어내거나(Hallucination), 아무런 응답도 생성하지 않은 채 침묵을 방치하여 고객이 “여보세요? 제 말 들리세요?”를 반복하다가 전화를 끊어버립니다.
1.2 멀티 모델 호출에 따른 이중 발화 (Double-Texting)
GECX 런타임에서 사용자의 1개 발화 턴은 내부적으로 복수의 LLM 호출(Multi-Model Call)로 쪼개져 처리될 수 있습니다.
- 1차 모델 호출: 사용자 의도 파악 및 안내 텍스트 생성 (“네, 고객님. 상담사로 연결해 드리겠습니다.”)
- 2차 모델 호출: 백엔드 상태 기록 툴 호출 (payload_update_tool)
- 3차 모델 호출: 세션 종료 신호 발행 (end_session)
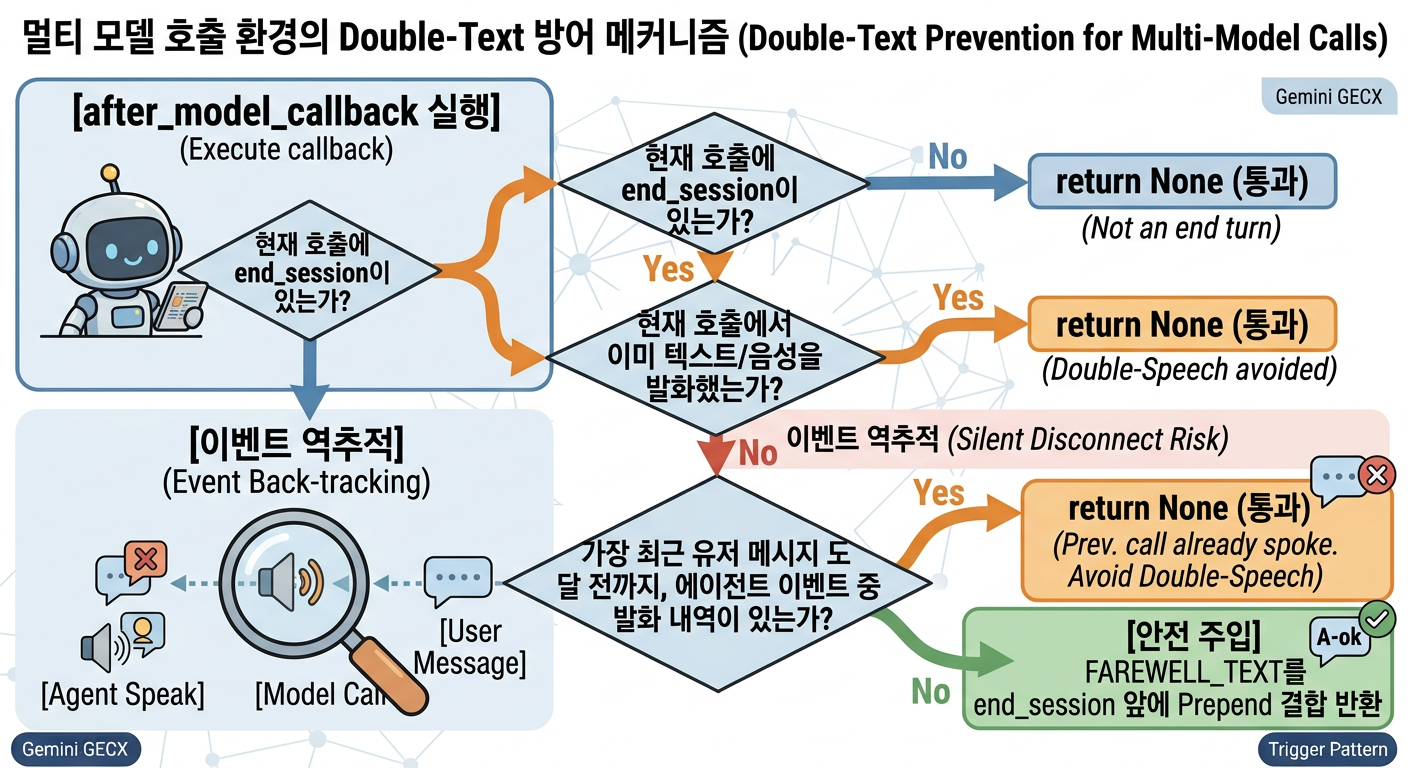
만약 종료 처리 콜백(after_model_callback)에서 단순하게 “응답에 end_session이 포함되어 있는가?”만 검사하여 작별 인사를 주입하면, 이미 1차 호출에서 멘트를 송출했음에도 3차 호출 시점에 멘트가 한 번 더 송출되어 고객에게 작별 인사가 두 번 연속 들리는(Double-Text) 참사가 일어납니다.
1.3 음성 트랜스크립트와 텍스트 페이로드의 불일치
양방향 실시간 오디오 스트리밍 환경에서 Gemini는 문자열(part.text)이 아니라 오디오 인라인 데이터(inline_data)와 전사 메타데이터(Transcript)를 반환합니다. 콜백 코드에서 part.text의 존재 여부만 검사하면, 실제로는 AI 음성이 정상 출력되고 있음에도 “텍스트가 비어 있다”고 잘못 판단하여 불필요한 기본 멘트를 덮어씌우는 오류가 발생합니다.
2. 침묵(Silence) 제어 아키텍처: 3진 아웃 프로토콜
고객의 무응답 상황을 프롬프트가 아닌 백엔드 콜백에서 제어하기 위해 “침묵 3진 아웃(Silence 3-Strikes) 프로토콜”을 구현합니다.
실전 구현 코드 (before_model_callback)
# agents/root_agent/before_model_callbacks/before_model_callbacks_01/python_code.py
import re
from typing import Iterator, Optional
# 1. 텔레포니 무응답 신호 감지 정규식
SILENCE_PATTERN = r”<context>no user activity detected for \d+ seconds\.</context>”
def is_user_inactive(contents: list) -> bool:
“””최신 유저 메시지가 텔레포니 침묵 이벤트인지 검증”””
return len(contents) > 1 and any(
re.search(SILENCE_PATTERN, p.text, re.IGNORECASE)
for p in contents[-1].parts if p.text
)
def get_reversed_agent_messages(contents: list) -> Iterator[str]:
“””이전 에이전트가 송출했던 멘트를 히스토리 역순으로 탐색하여 추출”””
for content in reversed(contents):
texts = [p.text for p in content.parts if content.role == “model” and p.text]
if texts:
yield “”.join(texts)
def handle_silence(state: dict, llm_request: LlmRequest) -> Optional[LlmResponse]:
“””침묵 3진 아웃 제어기”””
if not is_user_inactive(llm_request.contents):
# 고객이 정상 발화한 경우 카운터 리셋
state[“no_input_counter”] = “0”
return None
# 무응답 카운터 증가
no_input_counter = int(state.get(“no_input_counter”, 0)) + 1
state[“no_input_counter”] = str(no_input_counter)
# 1진 & 2진 아웃: 이전 발화 리마인드
if no_input_counter < 3:
reversed_msgs = get_reversed_agent_messages(llm_request.contents)
if no_input_counter == 1:
last_msg = next(reversed_msgs, “무엇을 도와드릴까요?”)
return LlmResponse.from_parts(parts=[
Part.from_text(text=f”말씀이 없으셔서 다시 안내해 드립니다. {last_msg}”)
])
else:
# 직전 1차 리마인드 문구를 건너뛰고 원래의 본 안내 메시지 추출
next(reversed_msgs, None)
orig_msg = next(reversed_msgs, “말씀을 듣지 못했습니다.”)
return LlmResponse.from_parts(parts=[
Part.from_text(text=f”고객님, 목소리가 들리지 않습니다. {orig_msg}”)
])
# 3진 아웃: 세션 확정 종료
return LlmResponse.from_parts(parts=[
Part.from_text(
text=”고객님의 응답이 없어 통화를 종료합니다. 도움이 필요하시면 다시 연락해 주세요.”
),
Part.from_function_call(
name=”end_session”,
args={“session_escalated”: False, “reason”: “no_input_limit”},
),
])
3. 멀티 모델 호출 환경의 Double-Text 방지 메커니즘
한 턴 내에서 여러 번의 모델 호출이 발생하는 GECX 런타임 특성을 안전하게 방어하기 위해, after_model_callback에서는 이벤트 히스토리 역추적(Event History Back-tracking) 기법을 적용합니다.
실전 구현 코드 (after_model_callback)
# agents/root_agent/after_model_callbacks/after_model_callbacks_01/python_code.py
from typing import Optional
FAREWELL_TEXT = ” 고객센터를 이용해 주셔서 감사합니다. 좋은 하루 되세요!”
def after_model_callback(
callback_context: CallbackContext,
llm_response: LlmResponse
) -> Optional[LlmResponse]:
has_end_session = False
has_text_this_call = False
# ————————————————————————-
# STEP 1: 이번 모델 호출에서 end_session 호출 여부 및 발화 여부 검사
# ————————————————————————-
for part in llm_response.content.parts:
if part.has_function_call(“end_session”):
has_end_session = True
else:
# [오디오 세이프 검증] part.text 대신 text_or_transcript() 사용
content = part.text_or_transcript()
if content and len(content.strip()) > 0:
has_text_this_call = True
# end_session이 없거나, 이미 이번 호출에서 무언가 말했다면 개입하지 않음
if not has_end_session or has_text_this_call:
return None
# ————————————————————————-
# STEP 2: 멀티 모델 호출 검증 (Double-Text 방어)
# 이번 턴의 이전 모델 호출에서 에이전트가 이미 멘트를 송출했는지 역추적
# ————————————————————————-
for event in reversed(callback_context.events):
if event.is_user():
# 가장 최근 사용자 발화 지점에 도달할 때까지 탐색
break
if event.is_agent():
for p in event.parts():
content = p.text_or_transcript()
if content and len(content.strip()) > 0:
# 이전 모델 호출에서 이미 발화했으므로 중복 주입을 방지함
return None
# ————————————————————————-
# STEP 3: 턴 전체에서 발화가 전무한 채 종료된 경우에만 확정 주입
# ————————————————————————-
new_parts = [Part.from_text(text=FAREWELL_TEXT)]
new_parts.extend(llm_response.content.parts)
return LlmResponse.from_parts(parts=new_parts)
4. 오디오 세이프 전사 추출: text_or_transcript() 패턴
엔지니어가 흔히 범하는 실수 중 하나는 콜백 검증 시 part.text만을 사용하는 것입니다.
# [위험한 안티 패턴]
if part.text and len(part.text.strip()) > 0:
has_text = True
왜 위험한가?
텍스트 채팅 환경에서는 LLM 출력이 part.text 필드에 순수 문자열로 채워집니다. 그러나 GECX Bidi RunSession(양방향 음성 스트리밍) 모드에서는 모델이 PCM 오디오 청크를 part.inline_data로 스트리밍하며, 텍스트는 전사 메타데이터(Transcript)로 격리되어 전달됩니다.
결과적으로 part.text는 None이거나 빈 문자열이 반환됩니다. 이를 모르고 검증 로직을 짜면 시스템은 “AI가 아무 말도 하지 않았다”고 판단하여 불필요한 기본 멘트를 덮어씌워 오디오가 겹쳐 송출되는 치명적인 결함이 발생합니다.
표준 솔루션
반드시 플랫폼이 제공하는 오디오 세이프 추상화 메서드를 사용해야 합니다.
# [권장 모범 사례]
content = part.text_or_transcript()
if content and len(content.strip()) > 0:
has_text = True
text_or_transcript()는 텍스트 모드에서는 part.text를, 오디오 스트리밍 모드에서는 전사된 Transcript 문자열을 자동으로 추출하여 반환하므로 채널에 독립적인 안전한 검증이 가능합니다.
5. 실시간 오디오 스트리밍과 Barge-in(끼어들기) 제어
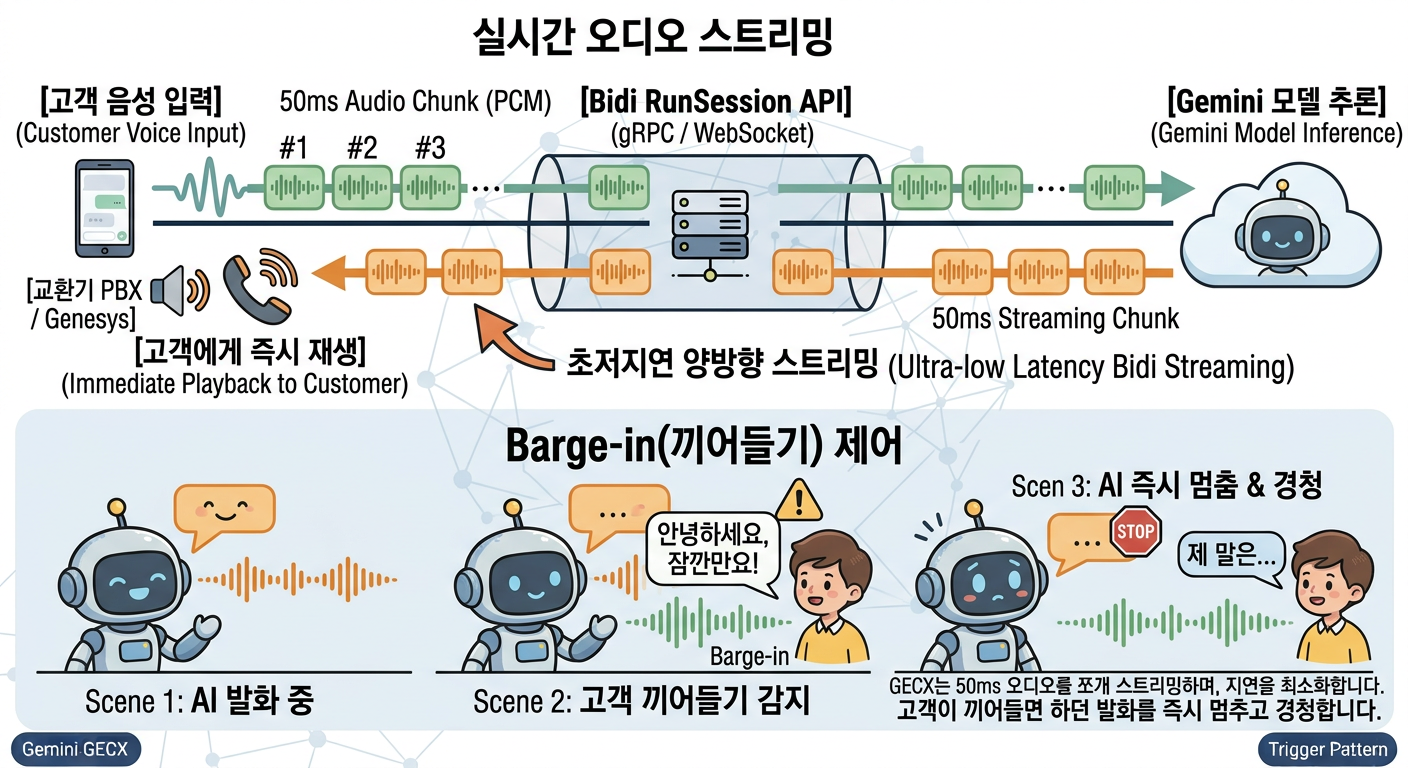
음성 통화의 핵심은 지연 시간(Latency)과 발화권 전환(Turn-Taking)입니다. GECX는 이를 해결하기 위해 초저지연 양방향 스트리밍 프로토콜을 사용합니다.
5.1 50ms 청킹(Chunking) 스트리밍
GECX의 Bidi RunSession API는 오디오 입출력을 50ms 단위(1초당 20개 청크)로 쪼개어 실시간 파이프라인으로 전송합니다. 문장이 모두 생성될 때까지 기다린 후 TTS를 돌리는 전통적인 방식 대비 First-Byte Latency를 수백 밀리초 단위로 단축시킵니다.
5.2 끼어들기(Barge-in) 충돌 제어와 Queue Flushing
AI 상담사가 긴 안내 문구를 읽고 있는 도중 고객이 “아니 그게 아니라요”라며 끼어드는 경우(Barge-in), 교환기와 서버 사이에서 양방향 패킷 충돌이 일어날 수 있습니다.
- 자율 응대(콜봇) 구간: 고객 음성 패킷이 게이트웨이에 감지되는 즉시, 재생 대기열에 쌓여 있던 AI의 오디오 큐를 즉시 플러시(Queue Flush)하고 gRPC 세션의 발화권을 고객에게 넘깁니다.
- 필수 안내 멘트 구간: 법적 필수 고지 사항(보험 약관, 결제 취소 수수료 안내)이나 계좌번호, 인증번호 안내 등은 고객이 중간에 말을 하더라도 끝까지 전달되어야 합니다. 이 경우 해당 세부 시나리오(Step)에서 시스템 파라미터로 Barge-in 허용 옵션을 일시 비활성화하여 청취 완결성을 강제합니다.
6. 단위 테스트(Eval) 자동화: pytest 시뮬레이션
1편에서 소개한 Trigger Pattern과 마찬가지로, 음성 특화 콜백 로직 역시 실제 음성 전화망이나 고비용 Gemini API 호출 없이 로컬 개발 환경에서 100% Mocking 기반으로 검증할 수 있습니다.
# evals/callback_tests/tests/test_voice_callbacks.py
import pytest
from unittest.mock import MagicMock
from python_code import before_model_callback, after_model_callback
from cxas_scrapi.utils.callback_libs import CallbackContext, Content, Part
def test_silence_strike_three_ends_session():
“””침묵이 3회 연속 누적되었을 때 확정적으로 세션을 종료하는지 검증”””
# 2회 누적된 상태를 시뮬레이션
ctx = CallbackContext(state={“no_input_counter”: “2”})
# 텔레포니 침묵 신호 모의 유입
silence_text = “<context>no user activity detected for 8 seconds.</context>”
llm_request = MagicMock()
llm_request.contents = [Content(role=”user”, parts=[Part(text=silence_text)])]
result = before_model_callback(ctx, llm_request)
assert result is not None
# 1. 안내 멘트 검증
assert any(“통화를 종료합니다” in p.text for p in result.content.parts if p.text)
# 2. 종료 함수 호출 검증
assert any(p.has_function_call(“end_session”) for p in result.content.parts)
# 3. 누적 카운터 확인
assert ctx.state[“no_input_counter”] == “3”
def test_double_text_prevention():
“””이전 모델 호출에서 이미 발화한 경우 작별 인사가 중복 송출되지 않는지 검증”””
ctx = CallbackContext(state={})
# 세션 이벤트 히스토리에 에이전트 이전 발화 모의 주입
mock_event = MagicMock()
mock_event.is_user.return_value = False
mock_event.is_agent.return_value = True
mock_part = MagicMock()
mock_part.text_or_transcript.return_value = “상담사로 연결해 드릴게요.”
mock_event.parts.return_value = [mock_part]
ctx.events = [mock_event]
# 현재 호출: 텍스트 없이 end_session만 호출됨
llm_response = MagicMock()
llm_response.content.parts = [Part.from_function_call(name=”end_session”, args={})]
result = after_model_callback(ctx, llm_response)
# 이미 이전 호출에서 발화했으므로 None을 반환하여 중복 발화(Double-Text) 방지
assert result is None
7. 결론 및 요약
| 음성 UX 지표 | As-Is (프롬프트 의존) | To-Be (음성 특화 콜백 엔지니어링) |
| 고객 무응답 대응 | LLM 환각 발생 또는 통화 방치 | 1·2차 리마인드 후 3차 확정 종료 (Silence 3진 아웃) |
| 통화 종료 UX | 침묵 끊김 또는 작별 인사 2회 중복 | 이벤트 역추적 기반 무결점 단일 작별 인사 보장 |
| 오디오 전사 처리 | part.text 누락으로 인한 오판단 빈발 | text_or_transcript() 추상화로 오디오 세이프 검증 |
| 오디오 지연 시간 | 전체 문장 생성 대기 후 TTS 변환 | Bidi RunSession 50ms 단위 스트리밍 및 Barge-in 제어 |
| 품질 검증 체계 | 실제 통화 테스트에만 의존 | Mock 기반 단위 테스트(Eval)로 CI/CD 자동화 |
- 시간 축(Time-domain) 위의 제약 극복: 실시간 보이스 오디오 스트리밍을 제어하기 위해 텍스트 챗봇과는 다른 침묵 3진 아웃(Silence 3-Strikes) 프로토콜을 적용했습니다.
- 이중 발화(Double-Text) 완벽 차단: 음성 세션 유입 타이밍 지연으로 인한 중복 전송 문제를 Event History Back-tracking을 통한 무시 패턴으로 안전하게 차단했습니다.
- 오디오 세이프 전사 처리: 백엔드 개발자들의 흔한 실수인 part.text 널 체크 안티 패턴을 방지하는 text_or_transcript() 추상화 모델을 제안하여 예외 처리 무결성을 달성했습니다.
자세한 내용이 궁금하시다면, 메가존소프트 문의포탈을 통해 궁금한 부분을 남겨주세요.